自回归生成可以增强 dLLM 的探索性(The Flexibility Trap: Rethinking the Value of Arbitrary Order in Diffusion Language Models)
1. Introduction
现代的 LLM 主要以自回归 (AutoRegressive, AR) 范式来生成 token。在这个范式中,模型严格按从左到右的顺序,每次生成一个 token。这种因果结构虽然高效,但由于强加了严格的线性依赖,限制了生成速度和探索灵活性。为了解决这些限制,研究人员提出了扩散 LLM (dLLMs)。与 AR 范式不同,dLLM 将文本生成视为一个去噪过程,其中一系列噪声被迭代地转化为连贯的文本。
相比 AR LLM,dLLM 的优势主要有一下两个优势:
- 并行性:dLLM 一次可以同时预测多个 token,能够显著加快推理速度;
- 灵活性:以任意顺序 (Arbitrary Order, AO) 生成 token 的能力使 dLLM 能够探索比 AR LLM 更大的解决方案空间。
1.1 Flexibility Trap
然而,作者发现,dLLM 的这种灵活性 (flexibility) 的优势并没有在实践中体现出来。相反,这种灵活性可能导致模型能够的多样性更差,最终限制了其推理潜力。作者的实验表明:
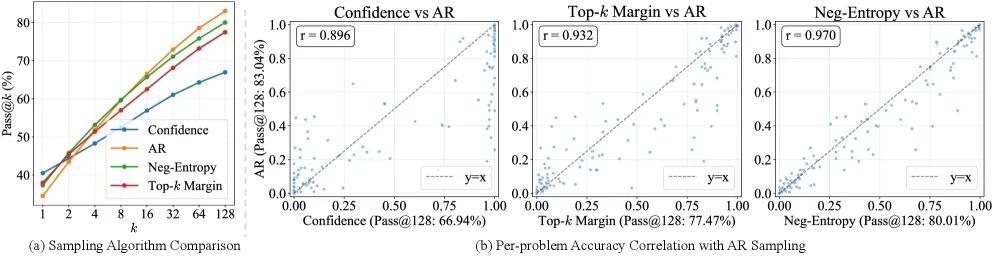
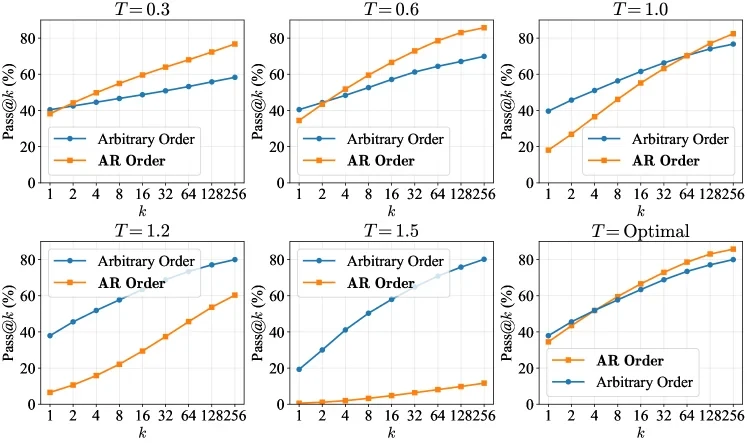
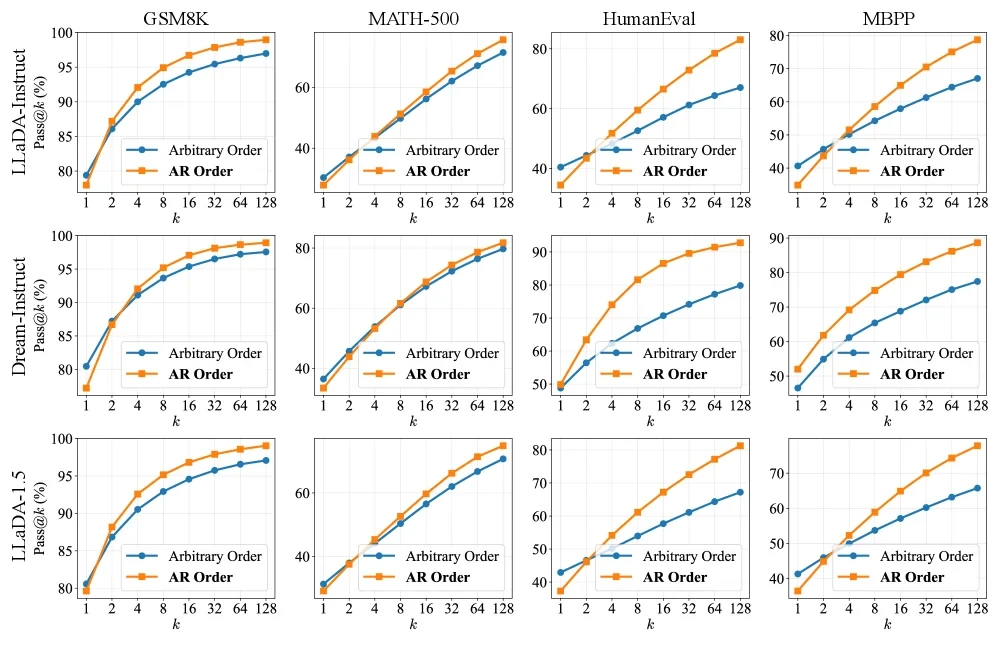
- 只采样一个样本时,AO 和 AR 的性能接近。
- 随着采样次数的增加,AR 的 Pass@k 指标始终优于 AO。
- 当采样次数达到 1024 次时,AO 找到的解决方案几乎完全是 AR 的子集。
这表明,看似灵活的方法实际上是在反复收敛于相同的几个解决方案,未能探索更加多样化推理路径。
1.2 为什么更高的灵活性无法得到更好的多样性?
为了解释这种 Flexibility Trap,研究人员在 AR 和 AO 的生成过程中,追踪了每个 token 的熵。当出现了一个高熵的 token,意味着模型看到了许多可能的有效路径,表明推理路径中存在一个分叉。对于推理多样性来说,这些高熵 token 至关重要,因为它们标志着逻辑向新步骤的过渡。
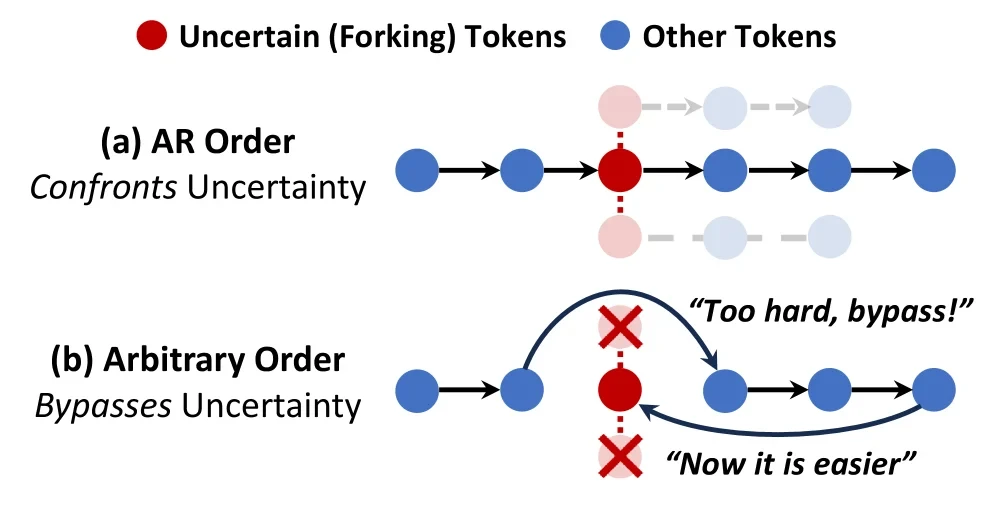
- 在 AR 范式中,模型必须正面应对这些分叉。它到达一个决策点,评估各种可能性,然后选择一个方向。
- 相比之下,AO 范式则倾向于绕过这些高熵(更困难)的 token,转而填充序列中后面出现的低熵(更容易)的 token。等到后面再来生成这些 token 时,未来上下文已经固定,这使得本身困难的分支逻辑决策变成了一个简单的对齐任务。
作者指出,AO 范式通过跳过现在先填充未来,抑制了推理过程的自然不确定性。这导致解决方案空间过早崩溃,模型无法有效探索解决问题的不同方法,而是试图让连接词适应预定的句子结尾。这种缺乏探索正是 AO 顺序的 Pass@k 曲线如此平坦的原因。
2. JustGRPO
基于对这种 Flexibility Trap 的观察,作者提出了一种用于 dLLM 的强化学习方法:JustGRPO。该方案的核心在于:在 RL 阶段强制 dLLM 严格按照从左到右的顺序来 rollout 和计算策略梯度,以此让 dLLM 的推理路径更加多样化。
具体来说,在 rollout 第
虽然 dLLM 会同时给出所有 [MASK] 位置的概率,但 JustGRPO 只取第
由此,作者构建了下面的 AR 策略:
有了这个 AR 策略,就可以完全套用普通的 LLM 强化学习算法,比如说 GRPO:
其中,
3. Experiments