多目标优化对齐(HarmonRank: Ranking-aligned Multi-objective Ensemble for Live-streaming E-commerce Recommendation)
📄 原文:KuaiShou · Arxiv · 阅读原文
1. Motivation
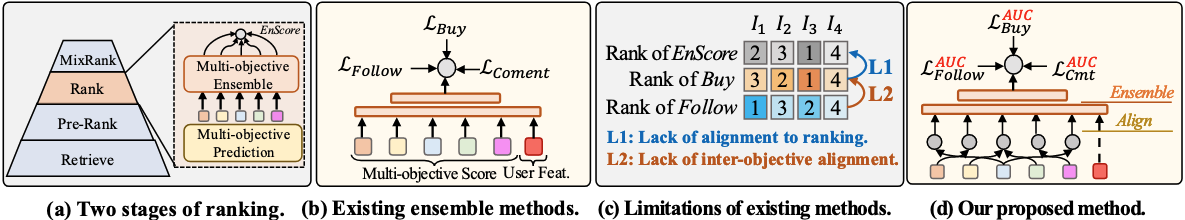
在精排阶段需要利用多目标预测对多个指标(如购买、评论、关注)分别进行预测,各自得到一个分数之后再通过集成模型最终输出一个精排分数。这个集成模型一般通过同时优化每一个指标的二分类交叉熵来训练:
这种范式存在两种显著缺陷:
- 二分类任务的优化方向和排序任务的目标(即 AUC 指标)不一致。
- 忽略了各个目标之间的对齐关系,如:评论和购买行为往往存在一定相关性。
2. Methodology
2.1. AUC 对齐
我们已有一个离线数据集
其中
由于上式不可微,因此不能直接优化。现有的 AUC 优化方法一般都是寻找一个可微的函数来替代指示函数
AUC 也可以用下面的 rank-sum 方式来计算(经典八股):
其中,
例:假设有5个样本(正负样本都有),其精排分数为 s=[0.7,0.2,0.8,0.1,0.9],则 r=[3,4,2,5,1]。
因此,我们只需要最大化
这里问题在于
原始的排序问题可以表示为在一个所有可行排列的集合
作者通过引入了集合
为了将问题转化为连续可微的优化问题,作者引入了一个二次正则化项,至此就可以把损失函数写成 MSE 的形式:
2.2. 优化目标对齐
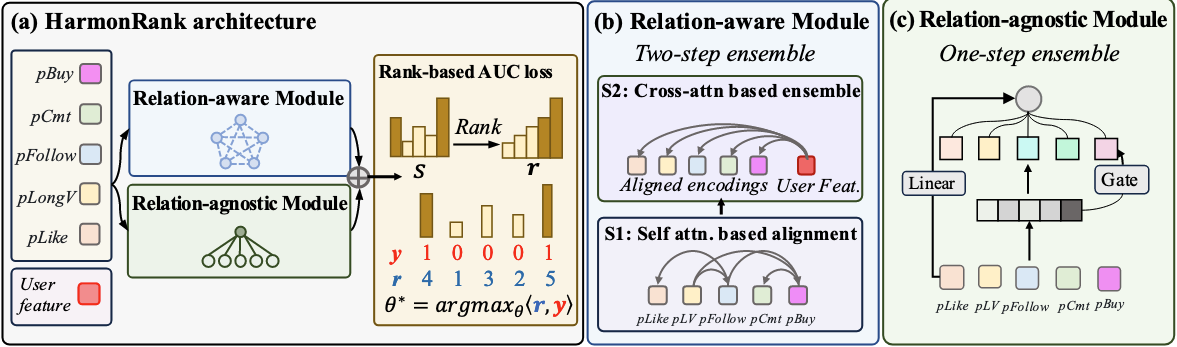
为了在不同的优化目标内部进行对齐,作者设计了两个通道分别对多目标分数进行融分:
- Relation-aware Module:两步融分
align-then-ensemble。第一步使用 self-attention 捕捉不同目标之间的关系,再使用 cross-attention 将各种分数融合到 user profile 表征上。 - Relation-agnostic Module:一步融分。使用一个 gating 模块来学习每个分数的权重。
最终的精排分数就是两个模块的输出分数之和。
3. Experiments
3.1. 端到端指标
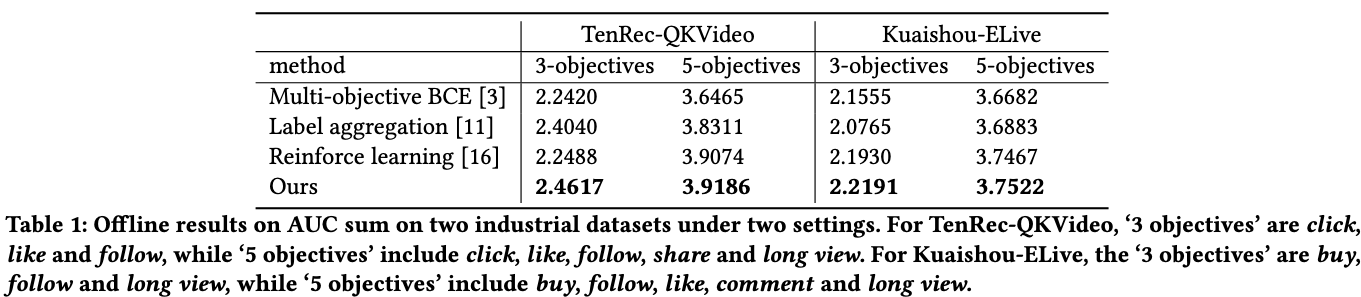
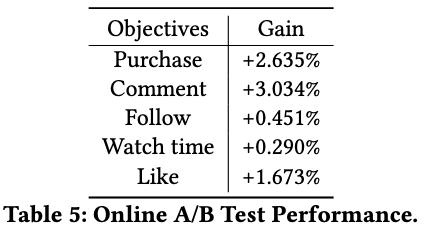
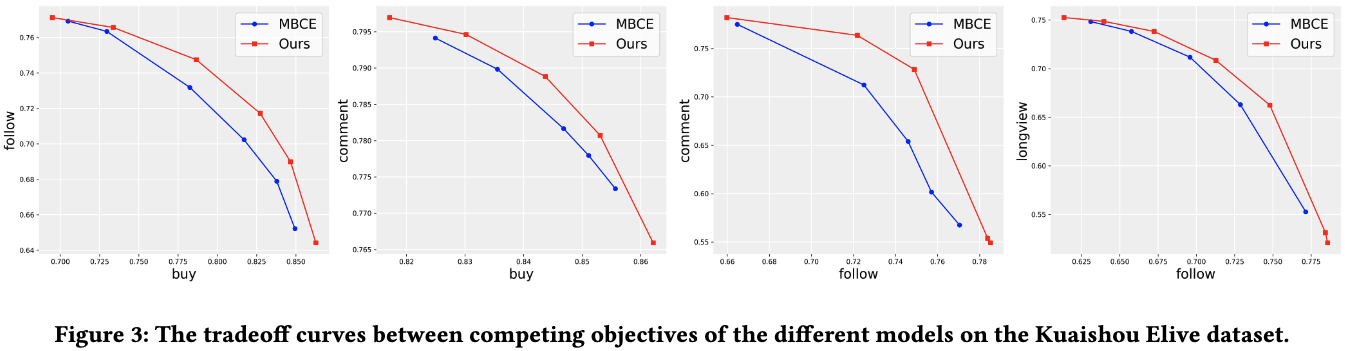
3.2. 不同业务指标之间的trade-off曲线
可以看到,HarmonRank可以让各种业务指标都保持相对较高的水平。