个性化搜索中的知识-动作对齐(KARMA: Knowledge-Action Regularized Multimodal Alignment for Personalized Search at Taobao)
📄 原文:Taobao · Arxiv · 阅读原文
一、Motivation
LLM 中拥有丰富的语义知识,理论上非常适合为个性化搜索系统注入语义泛化能力。但淘宝团队在实践中发现,直接对 LLM 进行个性化任务微调,效果往往不尽如人意。
研究团队发现核心问题在于Knowledge-Action Gap,即 LLM 预训练获得的丰富语义知识与个性化任务中的判别性目标(如点击预测)存在内在冲突:过度优化 Action 会严重扭曲预训练的语义空间,而冻结 LLM 又会导致表征过于粗糙,无法有效个性化。
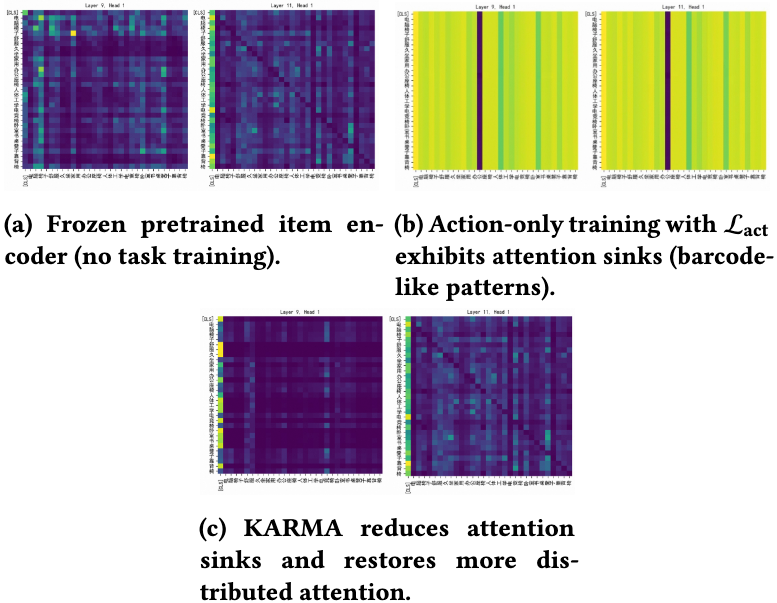
更严重的是,如果将每个物品压缩为单个 embedding,会出现 Semantic Collapse。此时注意力图退化成条形码状的模式,造成 attention sink 现象,模型就会用 ID 式特征而非真正的语义建模。
二、KARMA
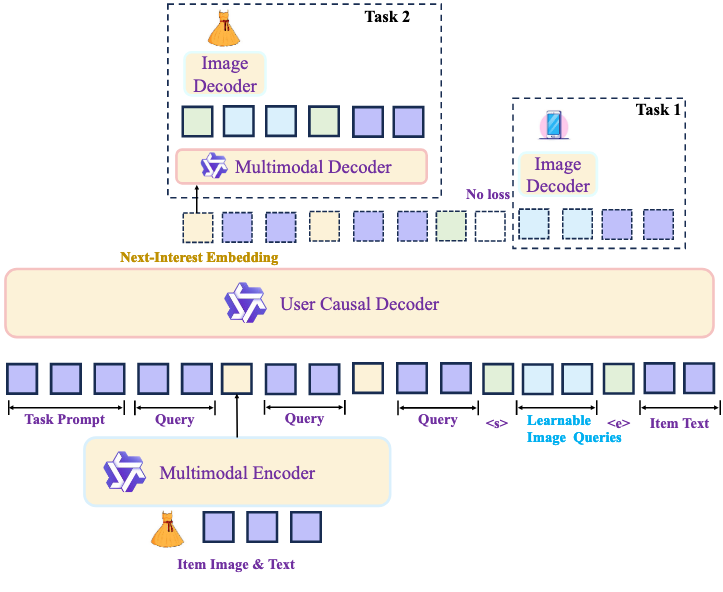
KARMA (Knowledge-Action Regularized Multimodal Alignment) 的核心思想:将语义重建作为训练时的正则化器。
- 为了更好地排序,表征应该与用户的动作对齐
- 为了保持语义知识,表征也应该具有可解码性,能够还原出目标物品的原始语义
为此,KARMA设计了以下目标函数:
其中,
KARMA 的关键设计思想是 Train-Heavy, Infer-Light,所有解码头仅在训练时使用,不会增加任何推理延迟。
2.1. 动作对齐目标
给定 query 表征
这种方式会比 InfoNCE 更加稳定。
2.2. 可解码性正则化项
2.2.1. History-conditioned Semantic Generation
令 ground-truth 物品的描述文本为
这种方式将训练锚定到 LLM 原生的 token 分布,缓解了灾难性遗忘。
2.2.2. Embedding-conditioned Semantic Reconstruction
这个目标要求 next-interest embedding 也是语义可解码的:
通过强制 embedding bottleneck,防止模型走 ID 式捷径。
2.2.3. 多模态扩展
当有多模态监督时,还可以使用条件 diffusion 或 flow matching 模型来重建视觉特征
其中,
Experiment
3.1. 离线实验
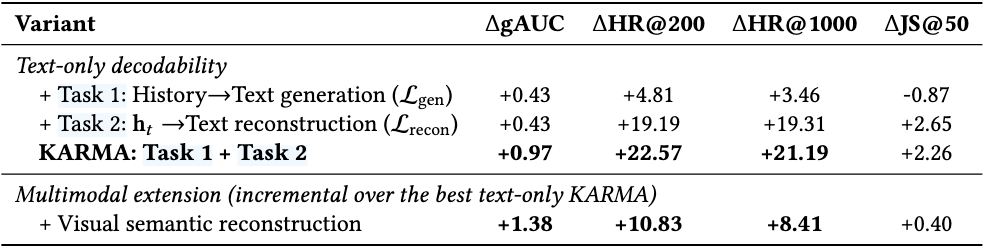
关键发现:
- Action-only 训练容易走捷径,语义保真度很低(JS@50)
- 两个正则化项互补,联合使用效果最佳。Embedding-conditioned 可解码性是主要的反坍塌约束
3.2. Mode-Mean Dilemma
有趣的是,论文发现扩散模型不适合作为检索 embedding 的生成器:
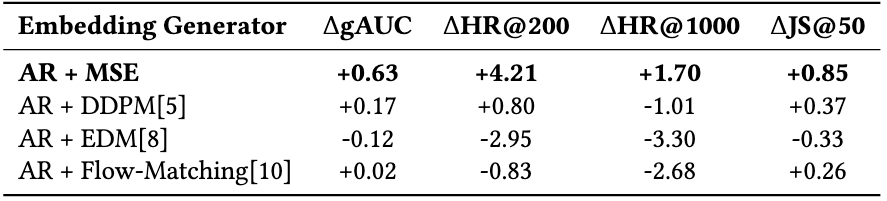
作者分析认为,扩散目标是 mode-seeking(采样高保真实例),而检索 embedding 需要 mean-seeking(作为稳定中心聚合多个可能的未来意图),这两者存在根本冲突。但作为语义正则化器,扩散模型的 mode-seeking 性质反而提供了有益的归纳偏置,帮助防止语义坍塌。
在附录中,我们从多个角度证明了这个结论。
3.3. 线上实验
KARMA 在淘宝搜索系统的三个阶段部署:
- 召回:+2.51 HR@5000
- 粗排:+1.86 HR@500
- 精排:+0.25 CTR AUC
14 天 A/B 测试:GMV +0.9%,且推理开销为零。
Appendix
为什么扩散模型适合做语义正则化器?
作为正则化器时,扩散模型的 mode-seeking 性质反而成为优势。我们从以下几个方面进行证明。
1. 流形正则化效应
假设商品图像、文本等自然数据分布在
其中
当用作正则化器时,我们优化:
这等价于在参数空间施加约束:
这防止了表示偏离数据流形,避免学习到奇异的、不在流形上的表征。
2. 隐式谱偏差(Spectral Bias)
扩散模型作为正则化器时,具有低频优先的谱偏差,这有利于语义稳定性。
考虑扩散过程的频域分析。设数据的傅里叶分解为
扩散前向过程在时域上表示为:
在频域上则表示为:
这里能得到一个关键结论:高频分量衰减更快。因为高频对应细节,低频对应语义结构。
在反向去噪过程中,优先恢复的是低频分量:
作为正则化器,这相当于只约束低频(语义)分量,忽略高频(噪声)分量:
这解释了为什么扩散模型能有效防止语义坍塌:它天然关注语义结构,而非表面细节。
3. 互信息最大化
扩散模型正则化近似最大化表征向量与语义的互信息。
考虑 InfoNCE 下界:
扩散模型的重建损失为:
最小化
action-only 的训练方式只最大化
KARMA 同时最大化
4. 防止表征坍塌
给定表征
其中,
- 当所有特征值都相同时,
,此时数据在各个方向上方差相同,占据整个空间。 - 当只有
个非零特征值时, ,此时数据坍缩到一个 维流形上。
表征坍缩 (Representation Collapse) 是指表征的有效维度
当扩散模型的重建损失很小时,表征的协方差矩阵的最小特征值存在下界。这使得协方差矩阵不会退化为奇异矩阵,有效维度不会太小,从而防止了表征坍塌。
设扩散重建损失为:
其中
1. 求解最优线性解码器
首先对
令导数为0,解得最优偏置为:
将重构损失展开并使用迹的性质:
对
假设
2. 最小重建损失
将
利用协方差的对称性
3. 求解特征值下界
要使
考虑二次型上界:对任意矩阵
令
因此:
整理得:
上述不等式给出了