利用PRM监督生成式推荐模型(PROMISE: Process Reward Models Unlock Test-Time Scaling Laws in Generative Recommendations)
📄 原文:KuaiShou · Arxiv · 阅读原文
1. Motivation
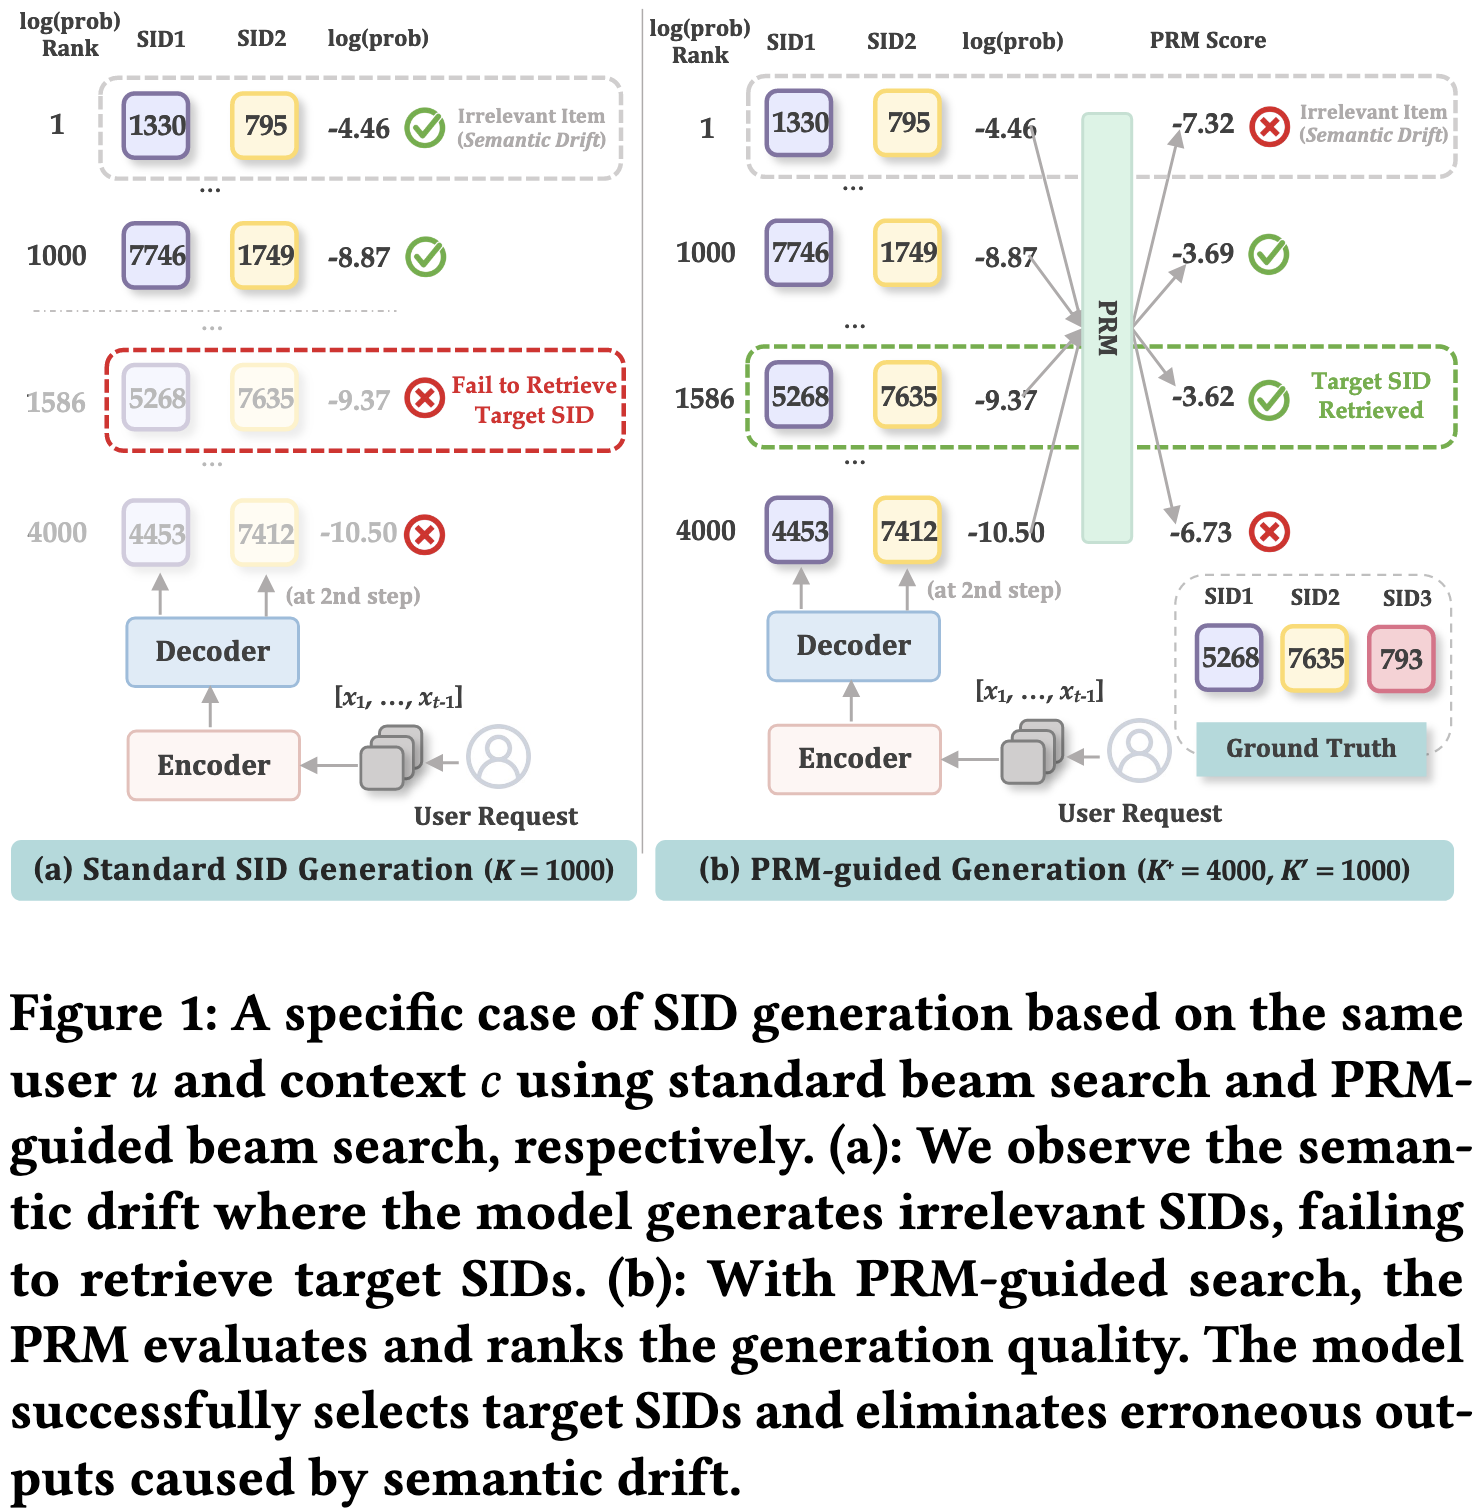
生成式推荐系统需要将item转变为语义ID (Semantic ID, SID),以此把next-item prediction的任务转变为和LLM相同的next-token prediction任务。
早期的SID编码方法一般是层次化量化(如RQ-VAE、Residual K-means等),将item的多模态语义embedding离散化为若干个token组成的序列,其中,靠前的token用于编码粗粒度语义和共性信息(如“电子产品”类),而靠后的token则用于编码细粒度细节和个性化信息(如“索尼耳机”)。
作者提出了这种语义编码的一个核心挑战:语义漂移(Semantic Drift),即由于误差累积导致生成的轨迹逐渐偏离用户的真实意图。
根因
作者认为,产生语义漂移的根本原因在于【曝光偏差】(Exposure Bias),即模型在训练和推理阶段存在不一致性:
- 在训练阶段,模型会根据真实的交互数据来预测下一个token。
- 在推理阶段,模型则需要自回归地根据之前生成的token来预测下一个token。
也就是说,模型在训练阶段从没有接触过自身预测错误导致的误差累积。
机制
这种曝光偏差的问题在SID的编码方式中会产生更加严重的问题。一旦靠前的token预测错误(如从“电子产品”类错误预测为“图书”类),后续所有细粒度预测都只能在错误的语义子空间中进行,导致推荐结果与用户真实意图偏离。
后果
这种语义偏移会导致模型在遇到OOD状态时,倾向于回归到训练数据的分布,加剧流行度偏差,生成长尾物品的能力受损。
语义漂移问题同样也会出现在LLM中,特别是在一些需要长CoT的任务上(比如数学推理、代码生成)。在这些问题中,中间步骤的一个小错误往往会导致最终的结果出错。为此,近期的研究提出使用过程奖励模型 (Process Reward Model, PRM) 来对生成的轨迹进行打分,以此缓解结果奖励模型 (Outcome Reward Model, ORM) 的奖励稀疏问题。
2. Methodology
2.1. Overview
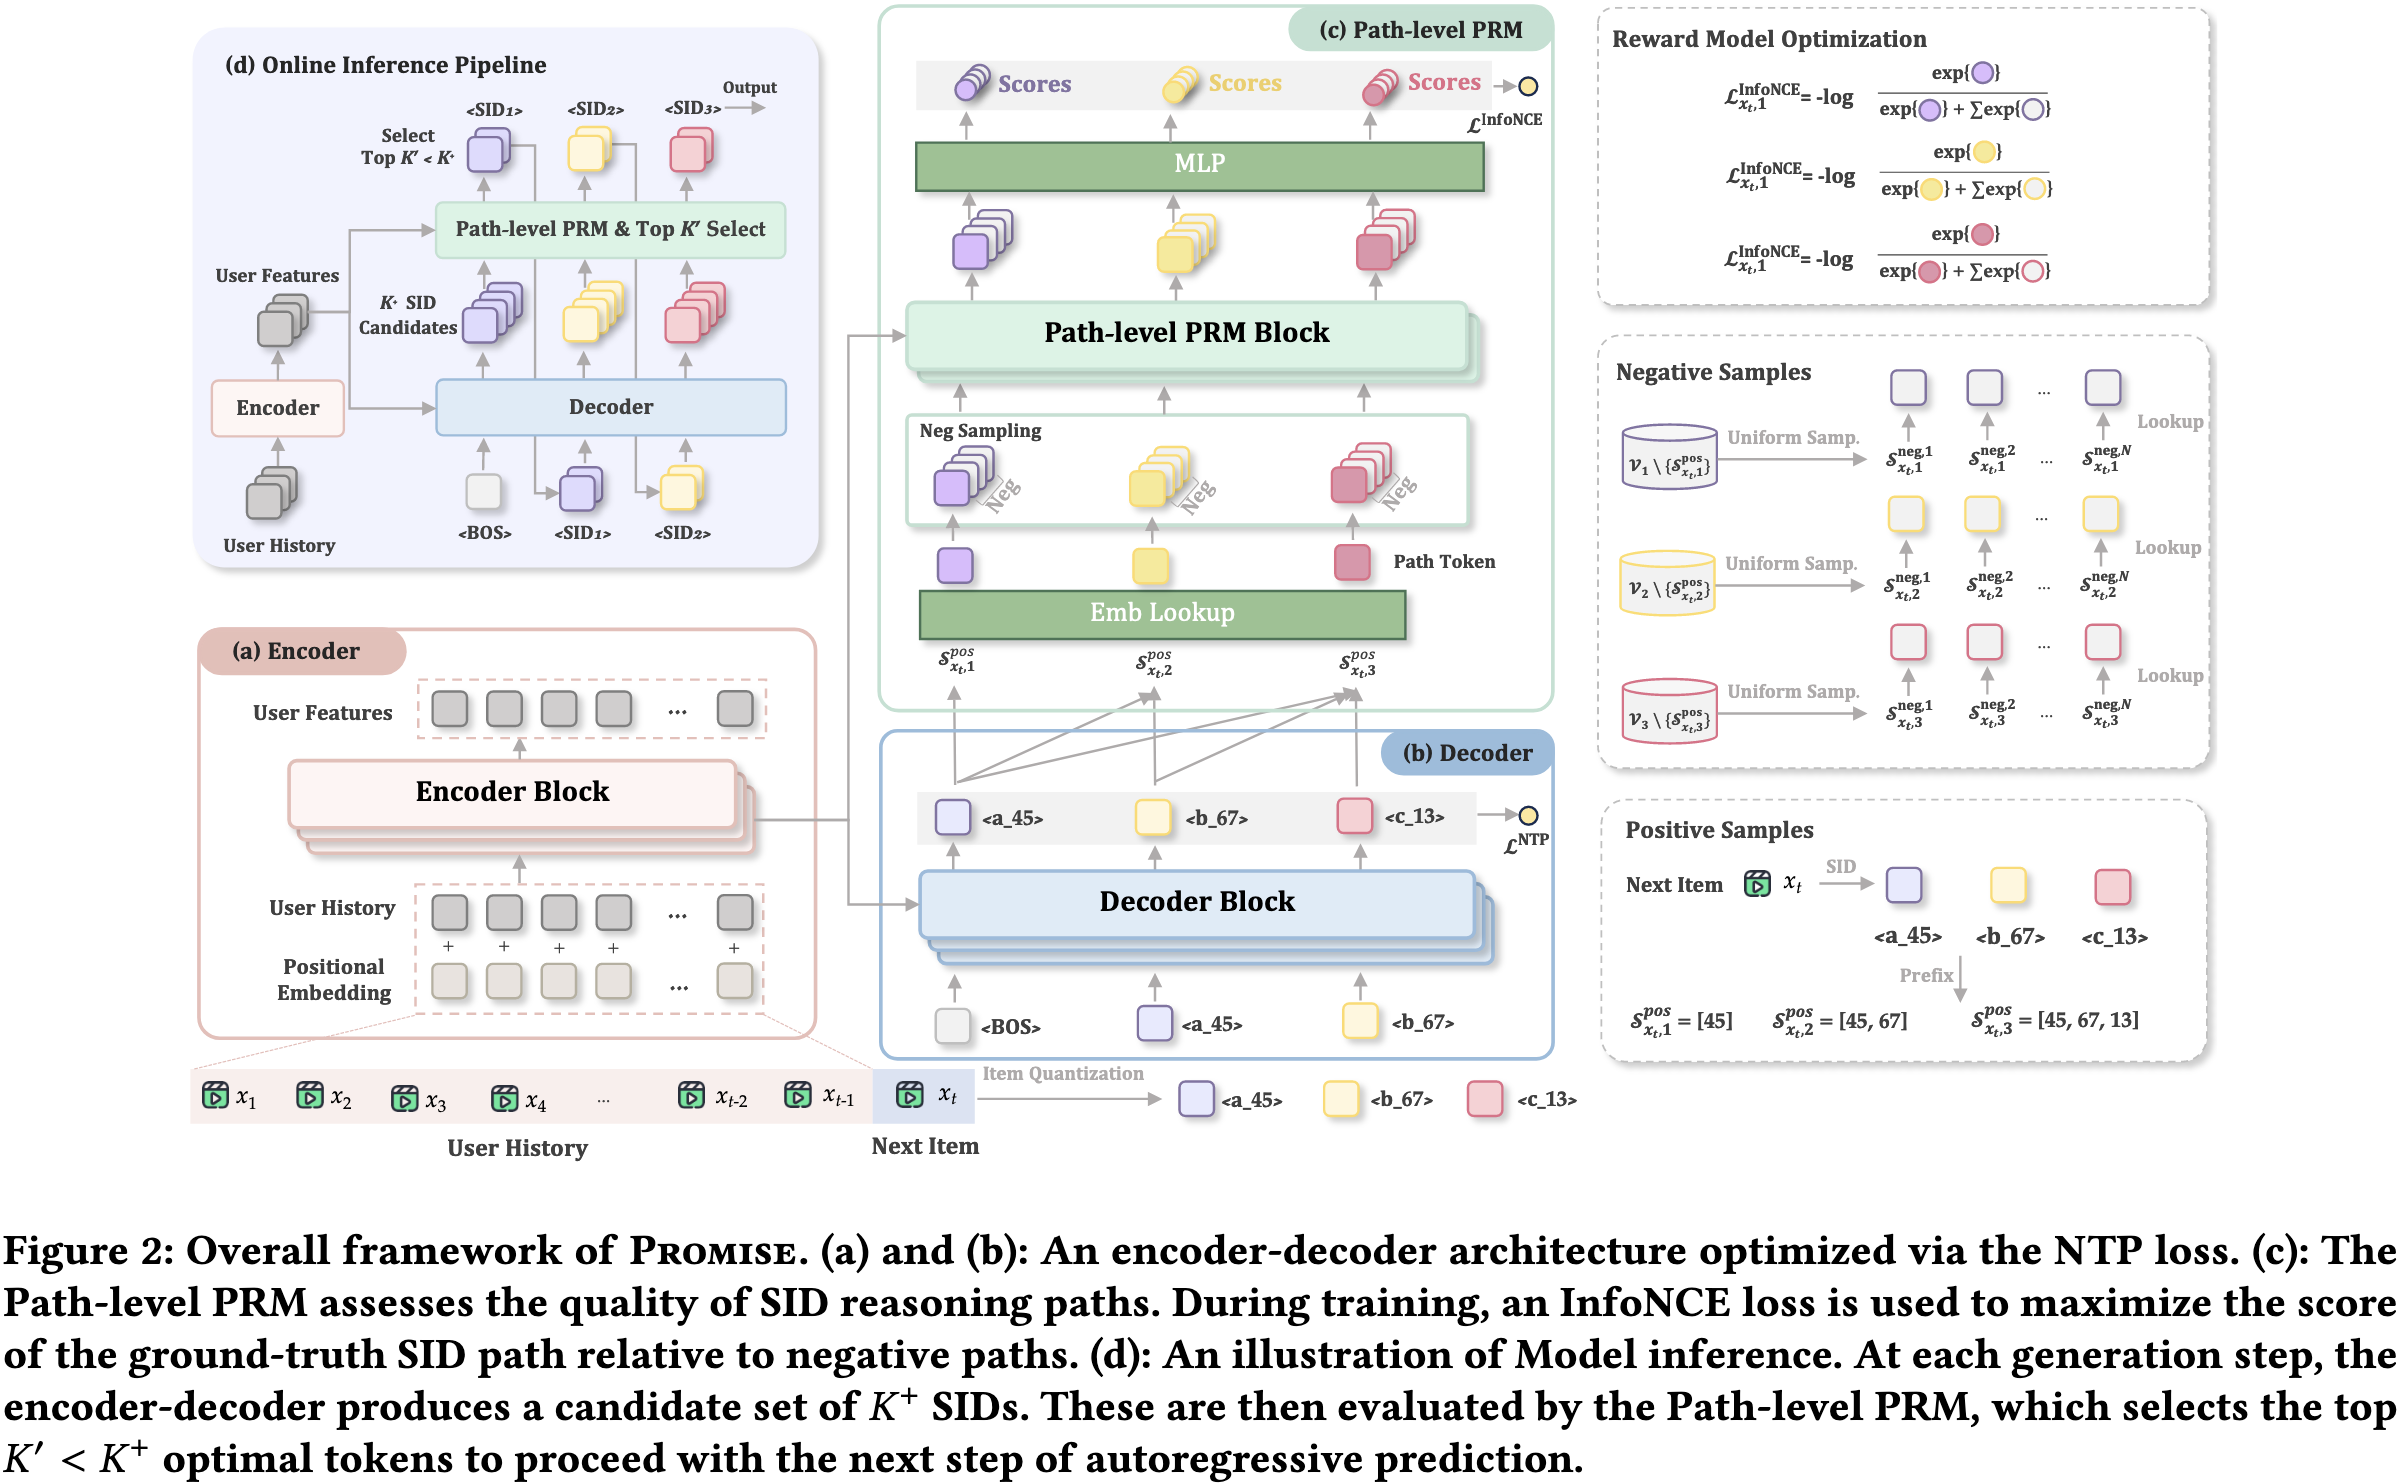
类比LLM中的做法,作者提出了PROMISE (Process Reward Model Unlock Test-Time Scaling Laws in Generative Recommendations),这是一个将过程奖励模型无缝集成到生成式推荐系统中的框架。PROMISE中包含两大组件:
- 路径级的PRM:和推荐模型一起训练,用于为中间推理步骤打分。
- PRM引导的Beam-Search策略:在推理阶段利用PRM的打分,对低质量的分支尽快剪枝,从而尽早暴露高质量的语义子空间。
更重要的是,作者发现PROMISE框架可以让生成式推荐系统具备test-time scaling的能力:当增加推理时的搜索宽度,小模型的表现甚至能够超过大模型。
2.2. Path-Level PRM
作者提出了一个轻量级、低延迟的PRM模型来为中间推理步骤打分。这个PRM是和推荐模型一起训练的,但是使用的训练数据则是采样生成的正负样本,因此避免了曝光偏差的问题。
2.2.1. 训练数据采样
正样本
假设ground-truth item
由于生成式推荐系统是逐个token地进行解码,因此想要正确地生成深度为
因此,
负样本
令
对于
2.2.2. 训练PRM
PRM的任务是给定user
作者使用层级InfoNCE来训练PRM:
这个PRM和推荐模型共同训练:
其中,
2.2.3. PRM的架构
为了在工业推荐场景下使用,作者设计了一个轻量级、低延迟的PRM架构。
PRM复用主干网络Encoder侧输出的用户表征
最后使用一个MLP输出分数:
实际上作者取
2.3. 推理策略
现代LLM表现出很好的test-time scaling的能力,即当增加推理时的搜索宽度,小模型的表现甚至能够超过大模型。借助上面的PRM,作者提出通过增加推理时candidate的数量,同样也可以让生成式推荐系统具备test-time scaling的能力。
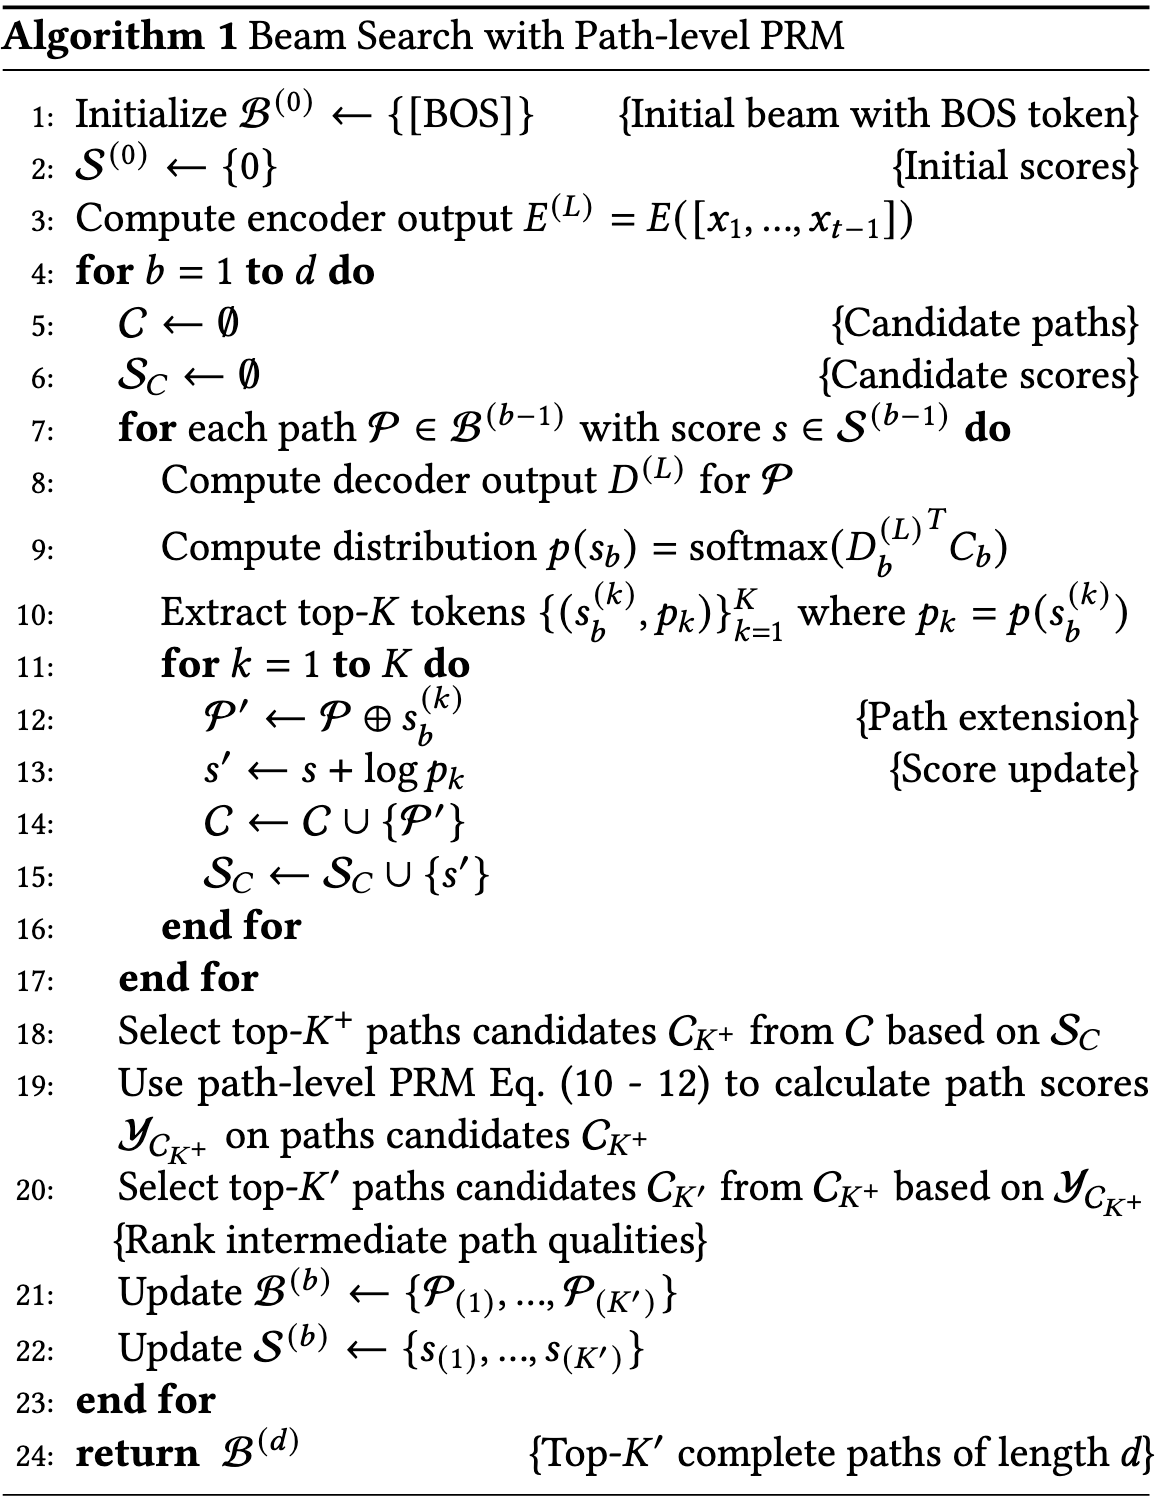
在传统的生成式推荐系统中,解码阶段使用固定beam-size的beam-search来生成token:在计算完logits之后,仅保留 top-
然而,PRM可以用较少的计算量来为每个candidate路径进行打分,因此我们可以让主干模型生成更多的candidates (
3. Experiments
3.1. 离线实验
公开数据集
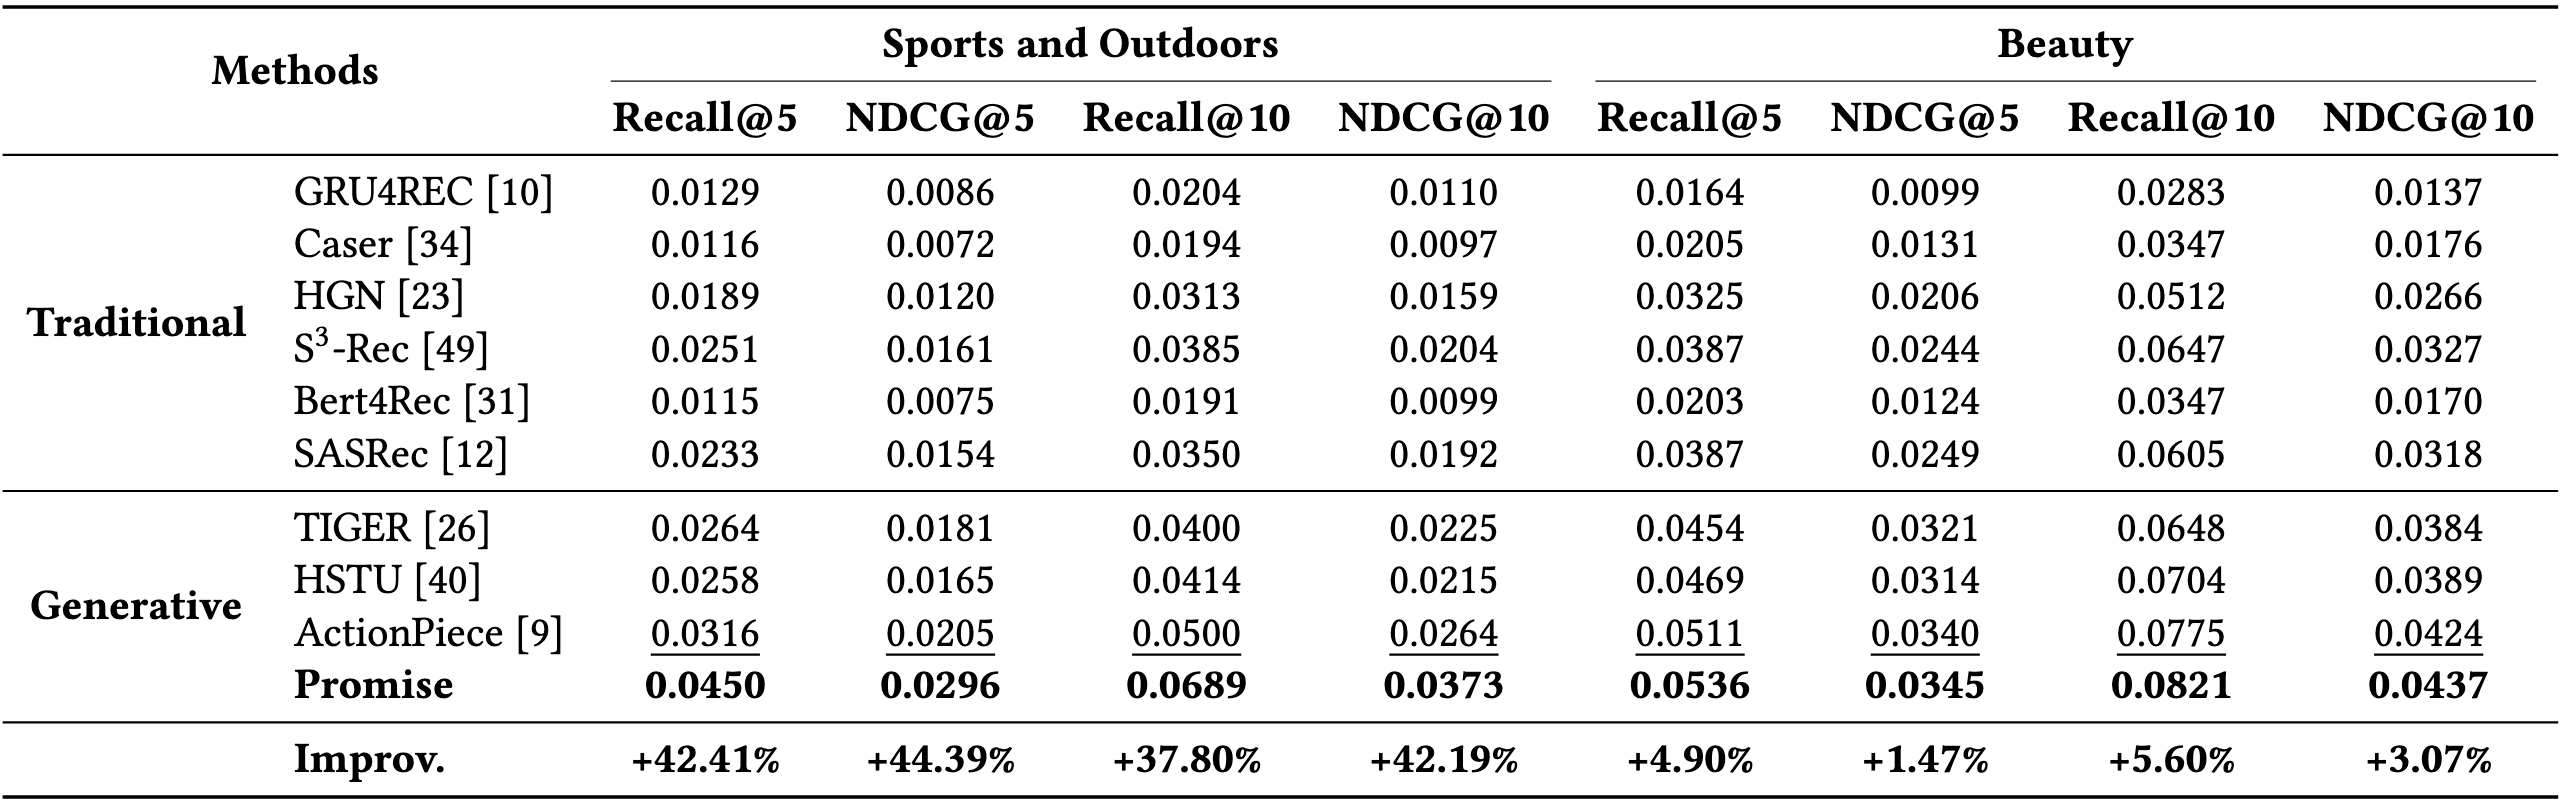
工业数据集
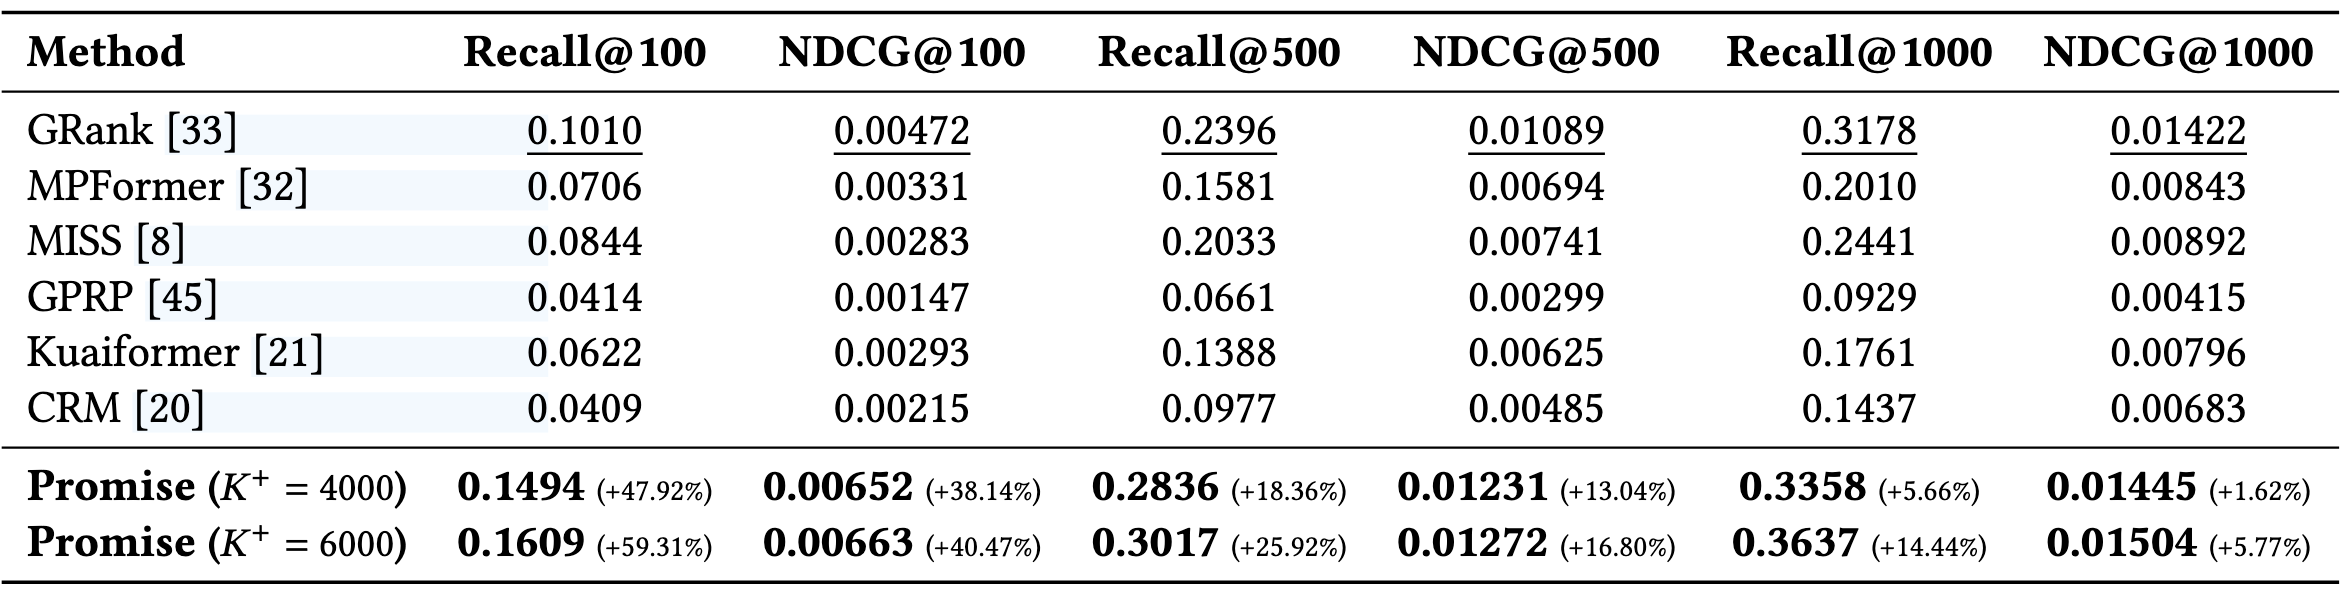
提升都非常非常大,甚至能到40%
3.2. 线上A/B
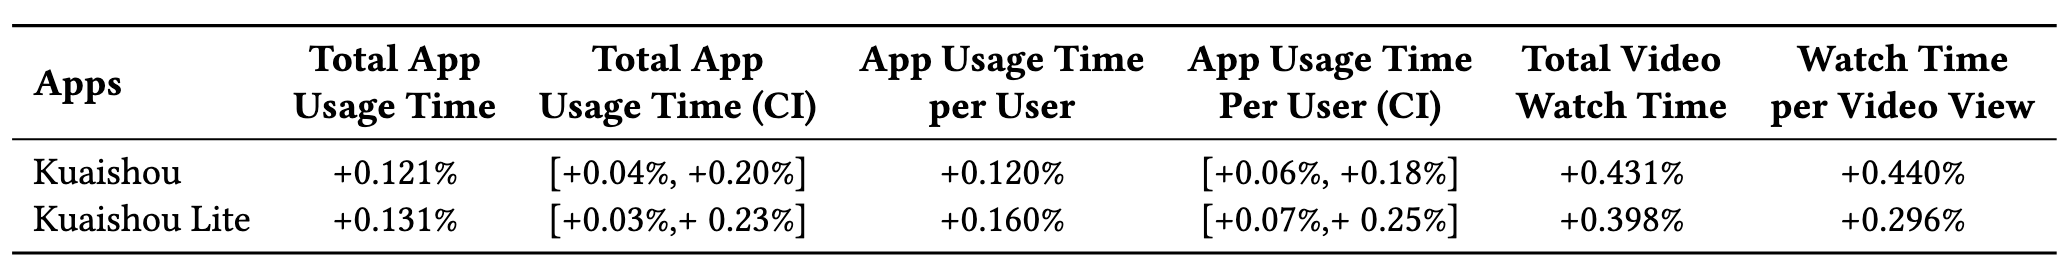
3.3. Test-Time Scaling
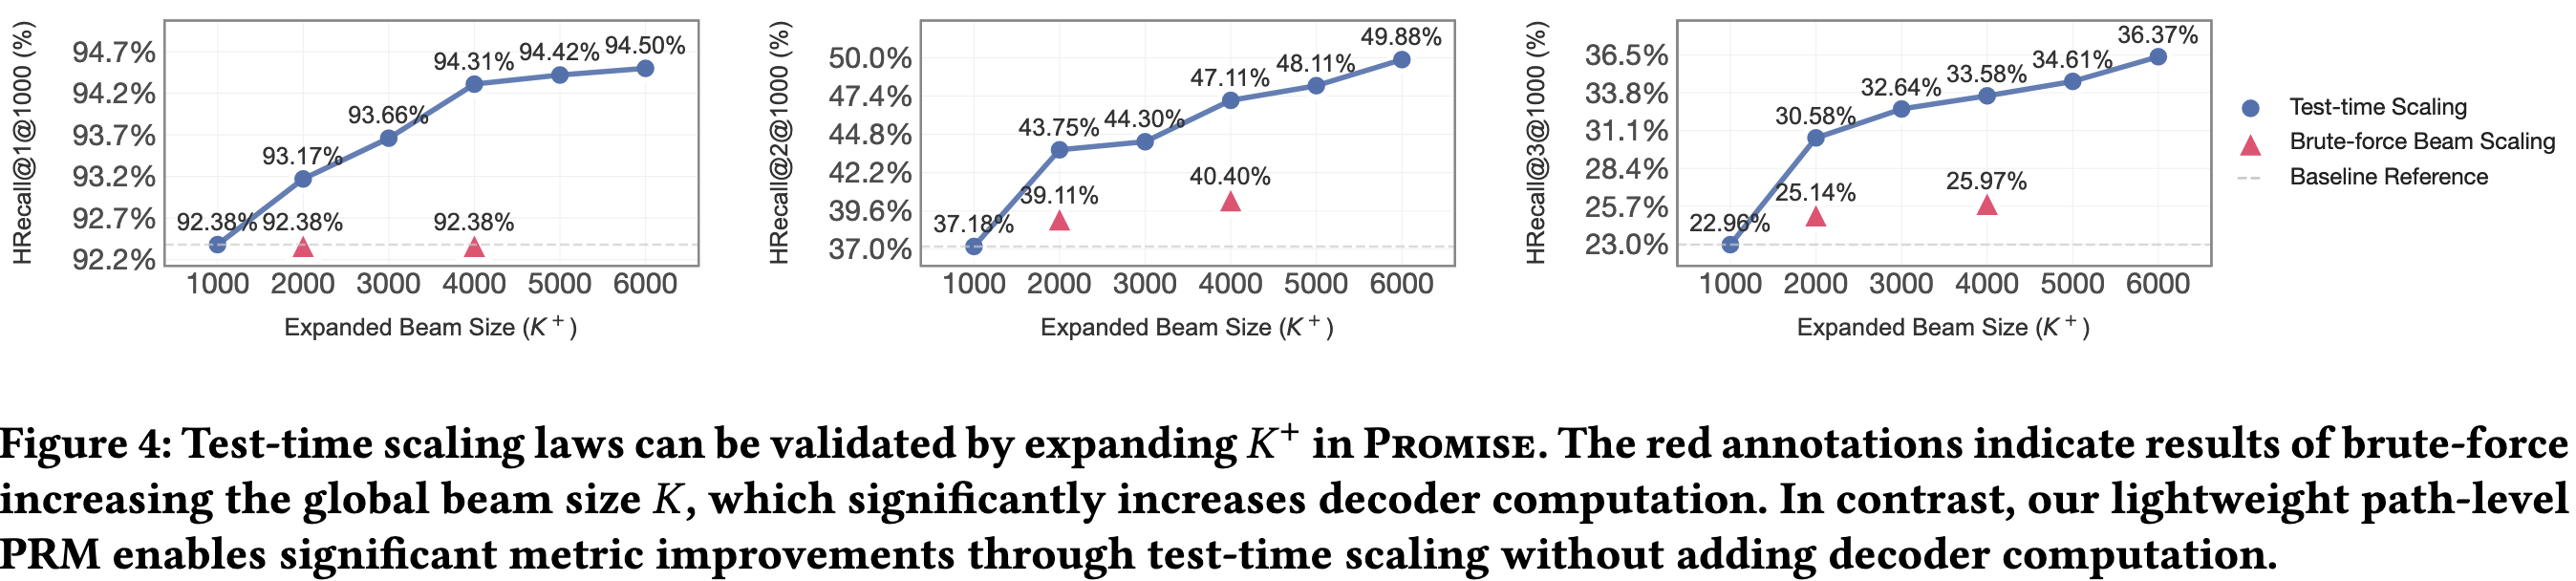
随着解码宽度