RFT的熵动力学分析(On the Entropy Dynamics in Reinforcement Fine-Tuning of Large Language Models)
📄 原文:Tongyi Lab · Arxiv · 阅读原文
1. Introduction
在本系列的前两篇文章中,我们已经分别介绍了策略熵、策略梯度算法对熵的影响,并且列举了一系列防止熵坍塌(即熵安全)的方法。在这篇论文中,作者以一个更微观的角度来看待策略熵的变化,并且将各种各样的熵安全方法在统一的理论框架下进行了总结和分类。
RFT面临着探索和利用 (Exploration-Exploitation) 的权衡难题,我们在RFT的过程中经常会遇到策略熵坍塌 (Entropy Collapse) 现象:随着训练进行,策略的输出分布迅速尖锐化,模型倾向于生成重复的、高置信度的“安全”回复,导致多样性丧失,最终陷入局部最优。
本文回答了以下三个问题:
- 为什么奖励高分答案会导致策略熵的下降?
- 每个token的更新如何影响策略熵?
- 如何从理论层面设计更加合理的熵安全策略?
2. RFT中的熵动力学分析
为了更好地分析RFT过程中的熵动力学,作者首先量化了单个token的更新会对策略熵产生什么影响。基于此,作者推导得到了GRPO算法对于策略熵的改变。
2.1. 单个token的影响
我们首先定义RFT更新的原子操作:我们对第
其中,
表示奖励token ,增加 。 表示惩罚token ,减少 。
下面的引理描述了这个扰动如何传递影响到整个策略分布:
Lemma 1 (first-order change of policy distribution). 对
Lemma 1 非常直观地说明了Softmax策略的性质:增加某个token的概率需要减少其他所有token的概率。此外,其他所有token概率减少的比例是相同的,只决定于
这表明,当一个token的logits增加时,其他所有token的概率都会等比例的减少。反之亦然。
基于此,我们就能够量化策略上的一阶改变量。
对于词表中的任意token
其中,
对于被更新的token
下面的定理1描述了
Theorem 1 (first-order change of policy entropy). 对
定理1表明:策略熵是增加还是减少,取决于更新方向
- 当
时, ,此时token 是相对低概率的 - 当
时, ,此时token 是相对高概率的
因此,我们可以得到如下结论:
- 奖励高概率token:此时
,即 。这是导致RFT中熵坍塌的主要原因:模型倾向于利用已知的高概率路径,奖励这些路径会进一步降低熵。 - 奖励低概率token:此时
,即 。这时策略被鼓励大胆探索,因此会熵增。 - 惩罚高概率token:此时
,即 。这迫使策略放弃当前的高概率路径,寻找新解。
2.2. 推广到GRPO更新
在使用GRPO训练时,我们的目标函数为:
其中,
因此,对于单个token
因此,当学习率为
其中,
下面的定理2说明了在GRPO的场景下,单个token
Theorem 2 (change of policy entropy by GRPO). GRPO算法对策略熵的变化量为:
值得指出的是,误差项
在实际场景下是非常小的。这是因为 ,其中 学习率 一般是 量级,重要性采样系数会被clip到1附近,优势项 会经过组归一化,一般也不会太大。因此, 基本都能满足。
定理2表明,在完整的一次梯度更新下,策略熵的变化不仅仅只取决于
基于定理2,作者进一步证明了如下两个推论:
Corollary 1 (entropy change of a token with online GRPO optimization). 当我们使用 on-policy 采样时,策略熵改变量的改变量期望为0:
Corollary2 (entropy change of a batch with online GRPO optimization). 当我们使用 on-policy 采样时,策略熵改变量的改变量期望为0:
这两个推论告诉我们,熵判别器的偏移量
3. Entropy Discriminator Guided Clipping
上面的理论分析为我们提供了一个全新的看待策略熵的视角:RFT的熵动力学和熵判别器
基于这种细粒度的分析,我们可以精确地找出那些容易导致熵坍塌的token,并对其加以约束,从而对训练过程中的熵进行精细而灵活的控制。
3.1. Clip-B: Batch-Normalized Entropy-Discriminator Clipping
给定一个batch
- 对于
中的所有token,计算其熵判别器分数: 。 - 计算batch内判别器分数的均值
和标准差 。 - 生成梯度掩码:
(14) 其中,
和 分别是判别器分数的下限和上限。 - 根据掩码
对其梯度进行裁剪,仅保留 的token的梯度。
Clip-B的优势有以下几点:
- 计算量非常小,仅需要在一个batch内进行均值和标准差计算。
- 不需要干预前向过程。
- 我们可以通过调整
来专门针对那些 较高的token,这些token比较容易导致熵坍塌。
3.2. Clip-V: Vocabulary-Level Entropy-Discriminator Clipping
Clip-V是一种理论上更严谨的方法,它在整个词表熵计算判别器分数的均值:
这种方式更加贴合定理2的条件,且能够更加精准地定位离群点,即相对于当前策略来说异常的token。
4. Experiments
4.1. 对比实验
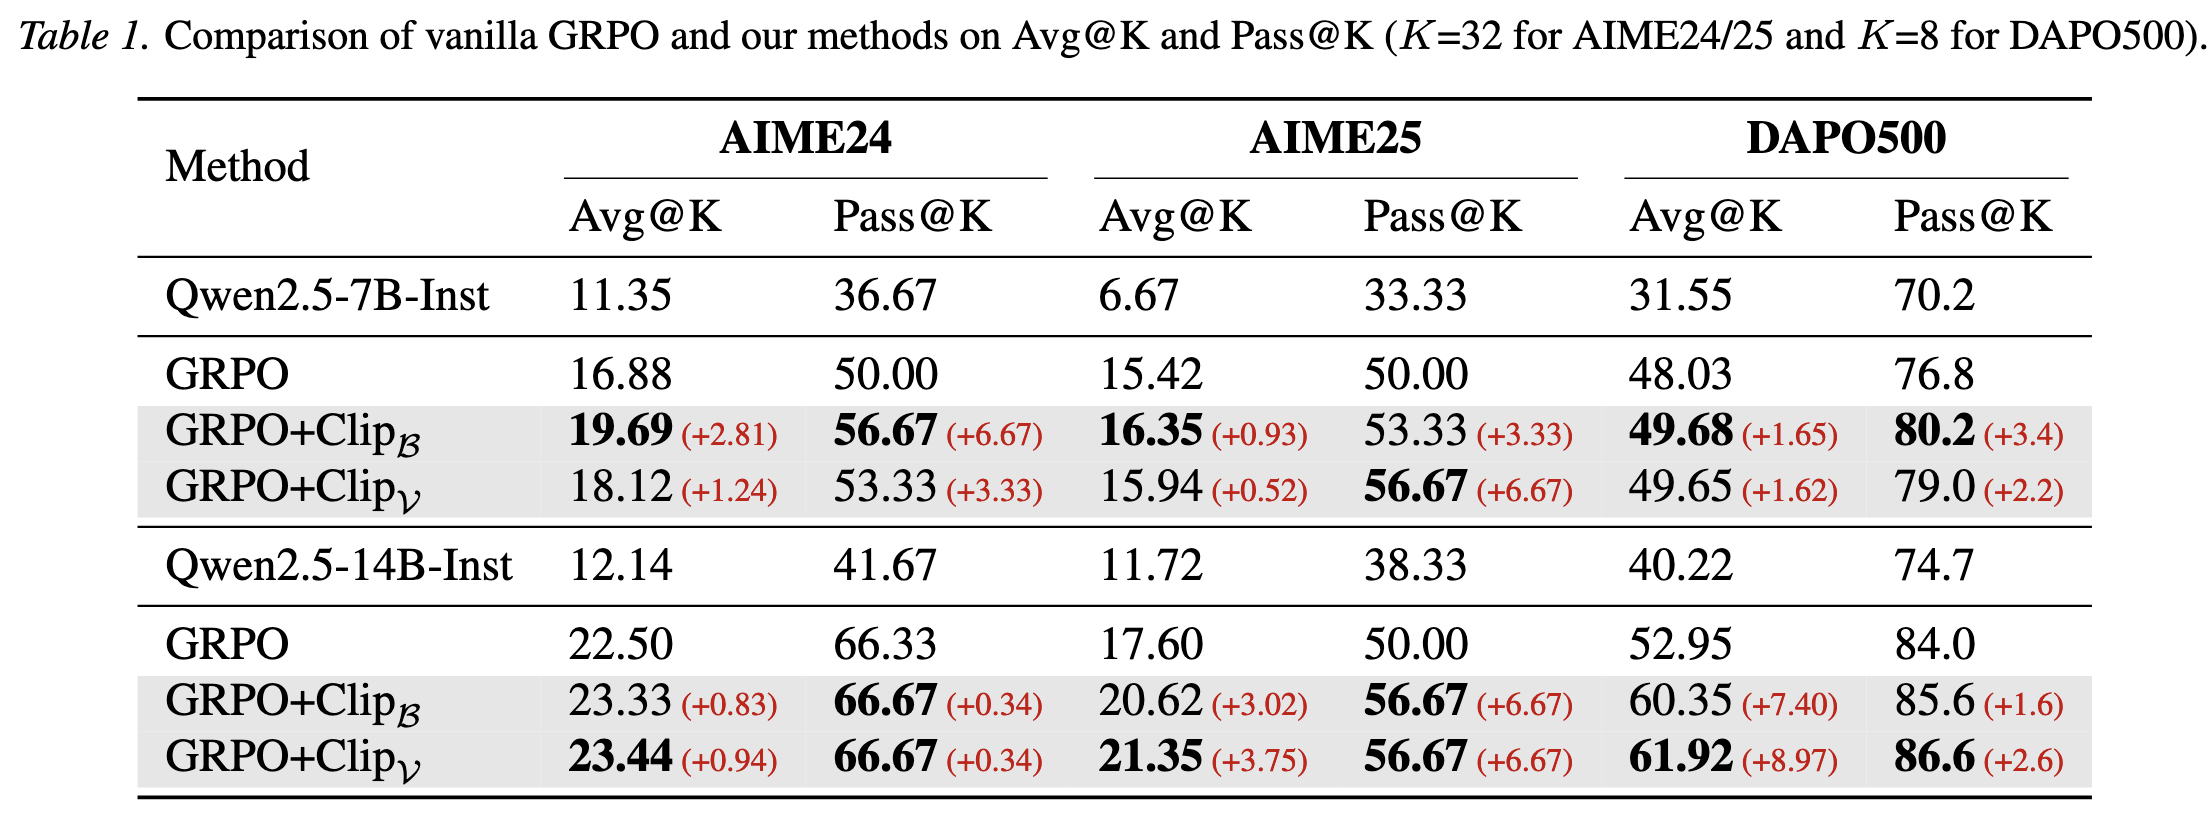
Pass@k显著提升,证明模型探索到了更多样化的解题路径。同时Avg@k也有提升,说明没有牺牲准确率来换取多样性,反而因为多样性的提升导致模型整体能力更强。
4.2. 熵判别器分数的预测能力
作者验证了判别器分数
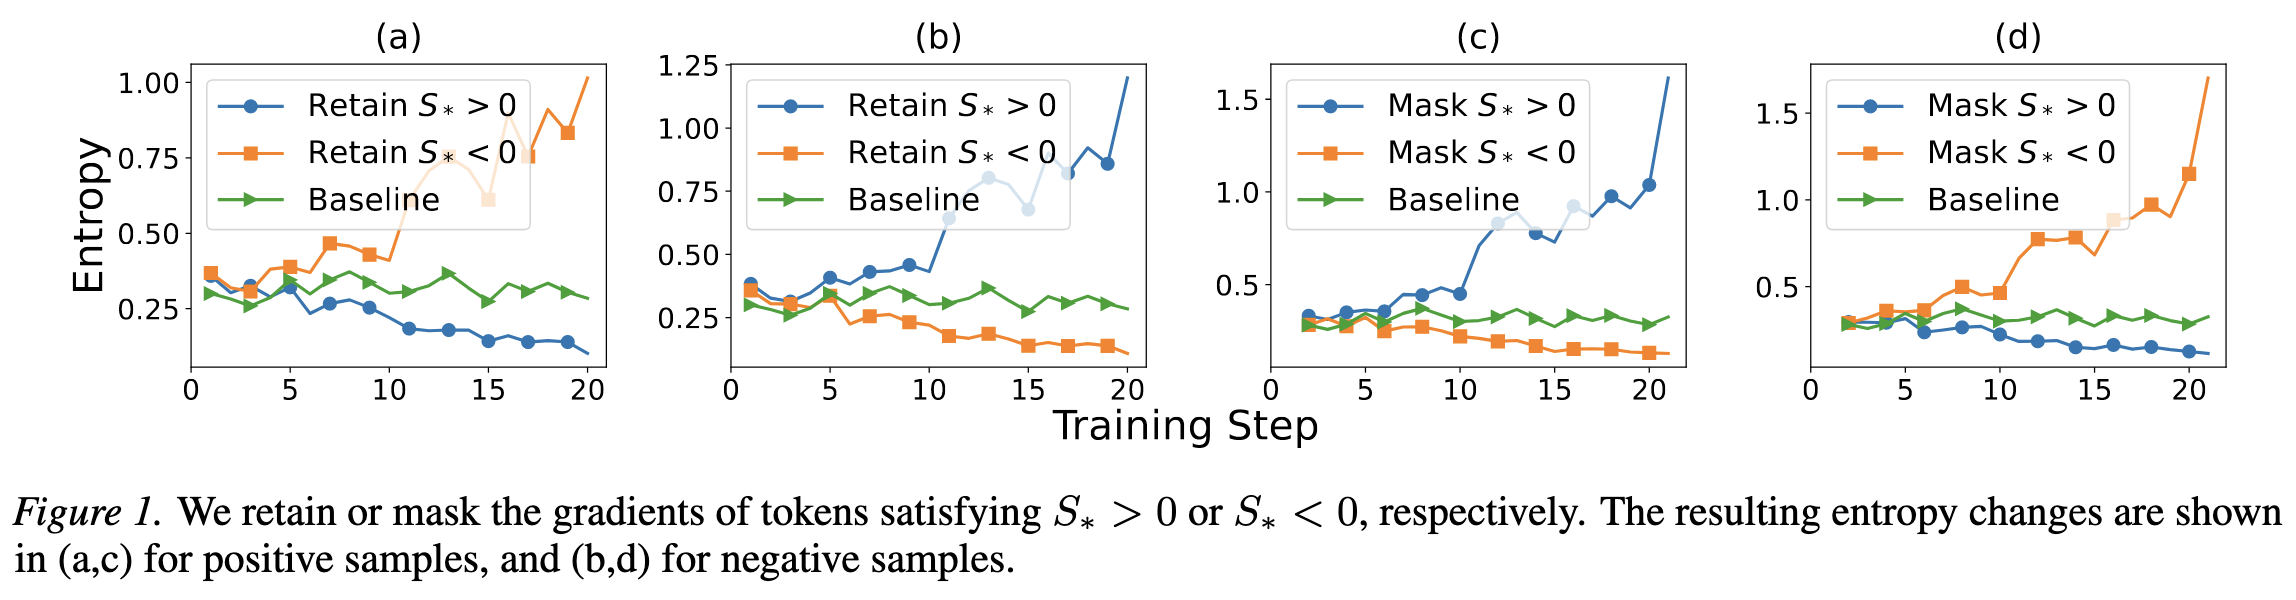
- 只留下
的token,熵显著增加 - 只留下
的token,熵显著减少
这与理论预测完全一致。
4.3. Clip-B和Clip-V对熵的影响
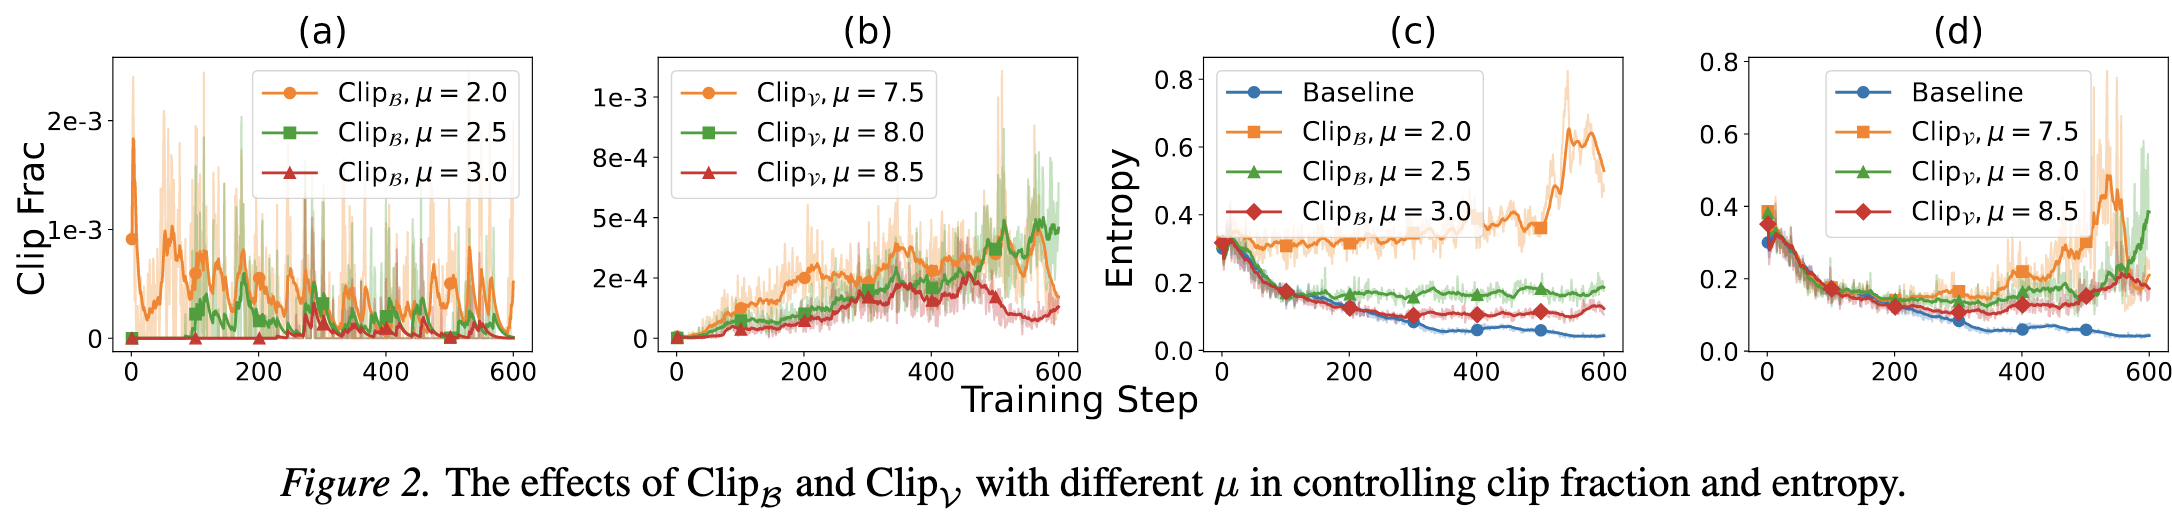
可以看到,当
Appendix
Apd.1. Proof of Lemma 1
下面我们来证明 Lemma 1 (2)。
对策略分布变化量
其中,
代入得:
得证。
Apd.2. Proof of Theorem 1
下面我们来证明 Theorem 1 (6)。
得证。
Apd.3. Proof of Theorem 2
下面我们来证明 Theorem 2 (11)。
首先我们来计算策略分布的变化量:
对于某一个分量
复用 (18) 中的结果:
其中,
因此,
定理2 (11) 得证。