随机过程(10):泊松过程(2): 过滤泊松过程
一、对泊松分布的深入认识
上一篇文章的最后我们提出了这样一个问题。考虑下面的条件期望:
如下图所示,我们现在有三种观点:
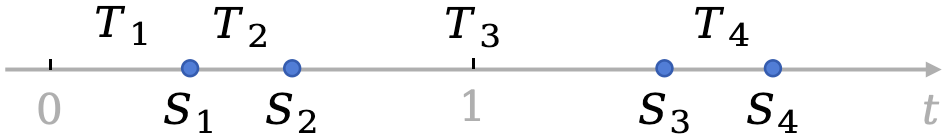
的长度服从参数为 的指数分布。 - 当我们在
内增加一个确定的时间点 ,由于指数分布具有无记忆性, 的长度也服从指数分布,但具体的参数未知。 - 上面条件期望的期望值为
。由于 的长度期望为 ,因此这意味着 的长度期望也是 。
这三个条件是互斥的,不可能全部正确。
我们现在来考察
当我们在
- 由于前一次事件发生在
之前,因此其下标应当是 。 - 同理,后一次事件的下标应当是
。
我们说
也就是说,我们实际上在求下面的随机变量:
这与上面的等式是不能划等号的,因为其下标有本质不同。
1.1. 给定发生次数下发生时刻的分布
下面我们来研究一下
解决问题的关键在于这个条件概率
真的就是指数分布吗?即条件
前面我们用过条件期望来分析随机个随机变量之和的期望。在那里我们特别强调,随机变量的个数
回到我们这个问题。当我们固定事件发生的次数
1.1.1. 一个简单的例子
我们先从一个简单的例子开始。考虑
因此,条件密度为:
在没有条件时,
1.1.2. 微元法求解一般情况
显然,在给定条件
这里很难再去做概率转换,因为情况实在是太多。这里我们需要使用微元法来求解,这是一种分析点过程的通用方法。
上面的式子中,我们只对每个随机变量设置了上界
也就是说,微元法是用一个个微元,把每个事件包围起来。只要令每个微元
- 有
个时间区间,每个时间区间长度为 。在每个区间内只发生了一次事件。 - 剩下的
时间内没有事件发生。 - 所有的时间区间内发生的次数都是相互独立的(独立增量)
更重要的是,求出上面这个概率之后,我们很简单就能直接得到我们想求的联合概率密度:
于是我们下面直接来计算:
这个结果看起来和
一个显然的证据是,这个概率密度积分甚至不是 1:
这里的问题出在:我们没有考虑微元的位置顺序。我们上面的计算想要成立,必须满足如下的顺序:
因此,正确的概率密度应该是这样的:
我们在附录1中证明了这个概率密度的积分是1。虽然这个事情本身没什么信息量,但是其中用到的对称函数积分这个技巧是很重要的。
1.1.3. 从顺序统计量的角度理解
现在我们来解释一下上面这个概率密度的概率含义。首先,我们引入一个新的概念,叫做顺序统计量 (order statistics)。
考虑一组独立同分布的随机变量
由于随机变量是一个从样本空间
其他的同理。
可以证明(附录2),这
与
1.2. 两次事件发生被某个时间截断
考虑泊松过程中相邻的两次事件发生时刻
首先我们写出联合分布的形式:
这个不太好分析,我们转而研究下面的联合概率:
因此:
进而,
同理,
综上所述,
因此,我们得出结论:
其实这里有一些小瑕疵。泊松分布的起点是从
开始的,因此 最长不会超过 。说明 并不是一个标准的指数分布,而是做了 min 截断操作。 但我们只需要让泊松分布的起点从
开始,就可以得到标准的指数分布了。
二、过滤泊松过程
上面我们已经认识到关于泊松过程的这样一个事实。
-
在一般情况下,事件发生时刻
是一个服从 Gamma 分布的随机变量。 (24) -
在给定事件发生次数
的条件下,事件发生时刻 的条件联合分布 (25) 则服从
个 的顺序统计量,其概率密度由公式 (14) 给出。
在这一节中,我们将利用这个认识,对泊松过程进行一个本质性的推广:去掉【独立增量】的条件。
2.1. 对独立增量的深入分析
泊松过程的独立增量性质是指:对于任意两段不重叠的时间段
我们指出,独立增量的本质就是:在
Note:非齐次泊松改变的只是事件发生时刻的分布。复合泊松则是改变单次时间发生的影响大小(但仍然不随着时间变化)。
2.2. 过滤泊松过程的特征函数
因此,想要放松独立增量的条件,我们实际上就是让每次事件发生所产生的影响【随着时间而变化】。也就是我们希望分析下面的过滤泊松过程:
其中,
我们考虑
- 这里不用矩母函数是因为没法保证
一定是取整数值,而矩母函数比较适合处理点过程。 - 需要指出,
中包含了三个随机因素: 、 和 ,因此条件期望是一种很重要的工具。
我们记
注意,
代回原式得
上面我们已经证明了,当给定事件发生次数
因此:
注意到这里的被积函数是一个关于
这个形式正好是标准泊松过程的矩母函数。因此:
我们来计算一下过滤泊松过程的均值:
2.3. 过滤泊松过程的几个习题
2.3.1. 发车问题
设一个公交站在一段时间
我们需要构造一个最优的发车计划,使得所有乘客的总等待时间的均值最小。
由于每次发车都会把所有乘客接走,因此不同车次之间的情况是相互独立的。我们只需要考虑单次发车的情况。
考虑在任意一个长度为
代入过滤泊松过程的模型中,我们的响应函数
因此,总等待时间的均值为:
假设某一个发车计划
此时,所有乘客的总等待时间期望为:
因此,我们的优化问题可以转化为:
这个优化问题的解是:
即等间隔发车。
这个问题比较简单,其实有个更加简单的方法:
这里有个很巧妙的方法。我们已经知道在给定
这里可以类比普通数值的情况,排不排序对于求和结果没有影响。
但我们还是要着重强调,这里
是一个随机变量,其顺序统计量并不是按照【大小】来排序,而是定义了全新的随机变量。 然而,即使在这种情况下,求和的结果仍然与排不排序无关。
因此,这里第二项的里层期望就直接等于
2.3.2. 公园内的平均人数
假设每天到达公园的游客是一个参数为
我们希望研究在某一时刻公园内的平均人数。
考虑在
其中,
因此,平均人数为:
2.3.3. 排队问题
考虑一个交换结点,数据包以参数为
这道题和上面的公园内平均人数是一样的,因此我们不再重复求解。我们这里的目的是介绍排队论的符号体系。
在这套符号体系中总共有三个要素:
- 怎么来的(到达的时间间隔)
- 如果到达时间间隔服从指数分布(即泊松过程到达),则记这个间隔为
(Markovian); - 否则,记这个间隔为
(General)。
- 如果到达时间间隔服从指数分布(即泊松过程到达),则记这个间隔为
- 怎么走的(服务时间)
- 同样地,按照服务时间是否服从指数分布,记为
或 。
- 同样地,按照服务时间是否服从指数分布,记为
- 服务体系中有多少资源(等待时间)
- 记为
- 记为
这个三元组是一套描述排队问题的公用符号体系,是由英国学者 Kendall 提出的。
比如说,我们上面的交换结点问题和公园内平均人数问题,本质上都是
为了解决
Appendix
Apd.1. 公式 (14) 是一个概率密度
我们来证明概率密度
的积分是1。
直接积分
当然,也可以这么写:
有个口诀就是【要么顶天要么立地】可以帮助记忆。
对称函数积分
上面的积分能做是因为被积函数是一个常数。但凡被积函数不是常数,这个积分都非常难算。
下面,我们来介绍一种积分技巧,即对称函数积分。
对于函数
对称函数的积分满足如下性质:
证明是显然的。
右侧的积分区域是一个
由于对称群中正好有
又根据对称性,对称函数在所有子区域上的积分都是相等的。因此,每个子区域上的积分正好是超立方体上的积分的
Apd.2. 顺序统计量的联合概率密度
现在我们来计算顺序统计量的联合概率密度。
首先,我们来考察一下
因此,其概率密度为:
同理,
因此其概率密度为:
一头一尾的都好做,比较难做的是中间的情况。我们来考察
这个时候做概率转换很难做。此时,我们考虑使用微元法,让
注意,这里的表述是前面还有
因此,我们有
这种形式的结果远远不止求一维概率,我们可以直接写出更高维概率分布的密度。比如说:
甚至,我们可以直接写出
当然,我们也不能忘了顺序的问题。所以实际上的联合概率密度为: