随机过程(8):高斯过程(4): 高斯过程的应用
一、DDPM
下面我们利用高斯过程的理论模型,来介绍一下大家耳熟能详的 DDPM (Denoising Diffusion Probabilistic Model)。
前面已经有一篇博客 生成模型 (1.3):Denoising Diffusion Probabilistic Model 详细介绍了DDPM,那里的推导更加的严谨和完整,有兴趣的读者可以自行查看。
1.1. DDPM概览
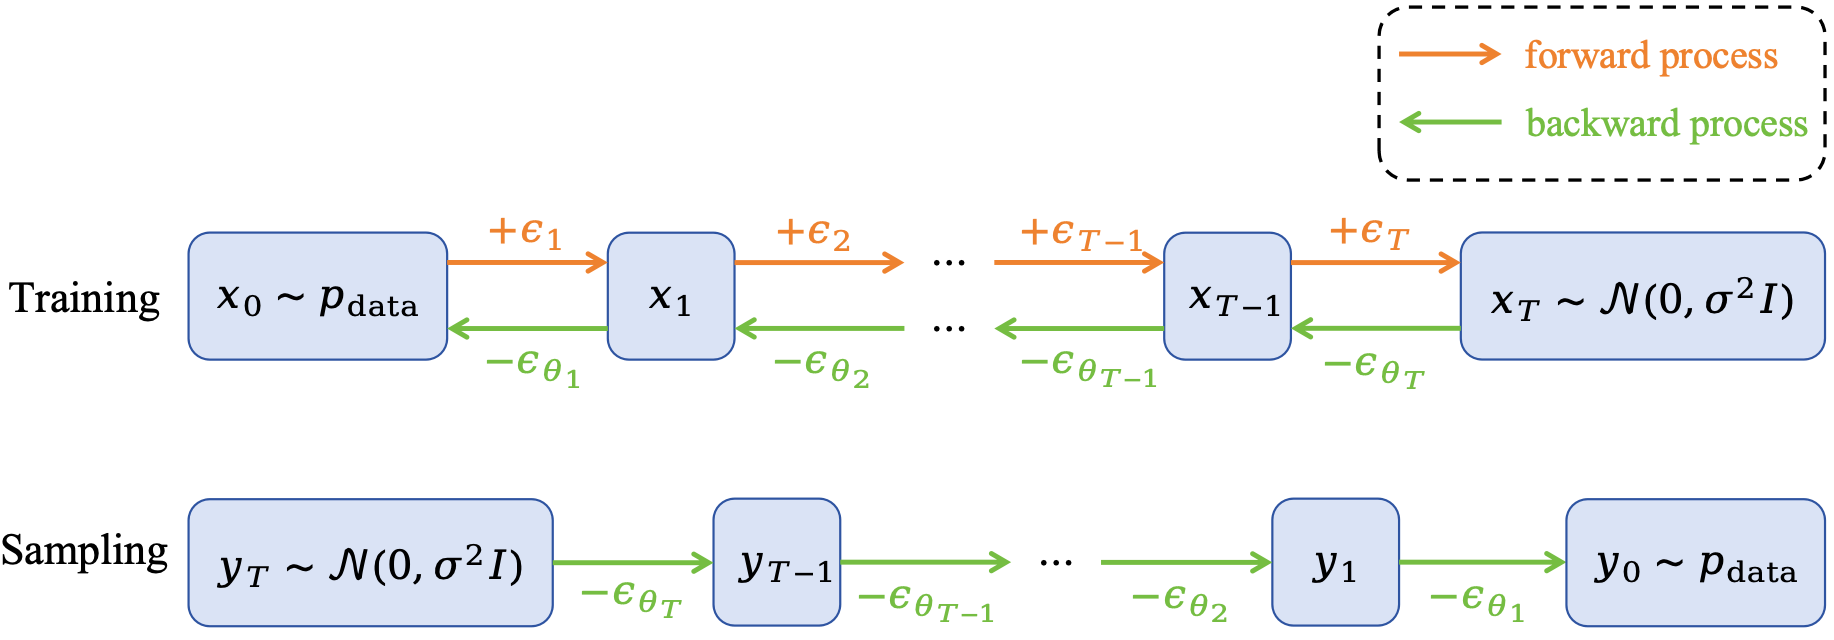
当前所有的生成式模型,实际上都是一个随机数生成器,它在某个分布上进行采样 (sampling),以此来生成一个随机数。然而,目标分布通常非常复杂且高维,直接对其进行采样是非常困难的。因此,一个很常见的想法是我们从一个简单的分布 (如高斯分布) 进行采样,然后通过一些变换,将其映射到数据分布上。
因此,生成模型需要学习的并不是目标分布本身,而是【从高斯分布映射到目标分布的方法】。
Fig.1 中展示了DDPM的理论框架,其DDPM的核心思想是:
- 在训练阶段,我们将目标分布逐步破坏为一个高斯分布(前向过程),通过学习前向过程的逆过程,来从高斯分布恢复出目标分布(后向过程)。
- 在采样阶段,我们从高斯分布中采样一个随机数,并利用学到的逆过程,逐步恢复出目标分布。
在前向过程中,每一步所加的噪声
1.2. 前向过程
在前向过程中,我们需要控制每一步所加噪声的分布,让我们能够更好地控制样本点的变化趋势。
具体来说,前向过程的递推表达式如下:
其中,
公式 (1) 表明,前向过程的每一步是上一步的数据点和标准高斯噪声的一个线性组合,并通过超参数
这个表达式的形式是经过精心设计的,它使得我们可以用优美的形式来直接写出前向过程的第
由于
因此,
我们记
公式 (4) 就是前向过程中任意时间步
1.3. 后向过程
在后向过程中,我们实际上希望对后验分布
Note:这里实际上已经用到了条件化技巧,即只考虑初始条件为
时的转移核。 更多关于条件化技巧的内容,读者可以参考 这里。
根据贝叶斯公式,我们有:
右侧的三个分布的形式我们都是已知的。
其中,根据公式 (1),似然
根据公式 (4),先验分布
同理,证据
因此,我们可以写出转移核 (5) 的形式。
由于是三个高斯分布,我们只考虑指数上方的二次型。注意我们的变量始终是
由此,我们可以知道,后验转移核也是一个高斯分布(指数上方二次型),且其方差为:
其均值为:
Note:上面的证明比较粗略,读者如果对严格的证明感兴趣,可以参考 这里。
1.4.
公式 (11) 中给出了后验转移核
然而实际发现,
这是可以做到的,因为公式 (4) 已经给出了噪声
代入 (11),我们可以得到:
因此,我们使用神经网络来估计这里的噪声项
二、线性高斯系统
下面我们来介绍线性高斯系统 (Linear Gaussian System)。
假设我们有一个系统,其中包括几个要素:
- 内在状态
(Intrinsic State),不能被直接观测到,类似于隐变量。 - 观测量
(Observation),能够直接观测到的数据,可以在一定程度上反映系统的内在状态。 - 噪声
我们希望通过观测量来推断系统的内在状态。最经典的建模方式是下面的线性模型:
即内在状态经过某种过程
同时,我们假设
根据高斯分布的线性性,我们很容易知道
事实上,我们有:
由于
我们希望研究的对象是
其中,
互相关矩阵
全部代入得,条件分布的均值和协方差矩阵分别为:
三、高斯分布的一些运算练习
3.1. n阶矩
设
首先,我们证明
根据高斯分布的线性性,这二者的联合分布为:
其协方差矩阵是对角矩阵,因此
因此,
下面,我们求
3.1.1. 直接积分
3.1.2. 矩母函数
一个随机变量
将矩母函数在
因此,矩母函数是求解
特别地,对于
将 (26) 在
-
当
为奇数时,系数为0,因此 。 -
当
为偶数时,有: (28) 从而,
(29)
综上所述,
3.2. 三角函数
在上面的条件下,求
扩展到一般情况,设
这里,我们没法像上面那样直接积分,而是要借助特征函数:
根据欧拉公式:
3.3. 不独立的情况
在上面的例子中,我们都不需要考虑条件
在上面的条件下,我们试图求
此时,联合分布变为:
对于这种情况,我们在这里直接阐述两个事实。
第一,我们可以把
其中,条件期望和条件协方差的形式我们在上一篇文章中已经详细推导过了:
因此,
第二,对于任意可测函数
因此,
四、判别分析
我们现在来讨论一下判别分析 (Discriminate Analysis),也就是分类问题 (Classification)。
假设我们有
我们的任务是分析这些数据,并将每一个数据归到一个类别中。
一个基本的想法是计算每个数据
但这种做法有一个显而易见的问题,即这种方法要求各个类的大小(即协方差矩阵)基本一致。为此,也可以有下面这种归类方式:
上面的公式就是机器学习中著名的马氏距离 (Malanokis Distance),也就是用方差对距离进行归一化。对方差进行归一化之后,就使得每一个类的大小几乎一致。
马氏距离的问题是只利用了数据,没有考虑先验知识。为此,我们可以使用贝叶斯公式,在给定先验概率
其中,根据高斯假设:
当没有先验知识,即
进一步地,当所有的协方差矩阵都相同
注意到,对于任意的类
由于中间的
这就变成了 softmax 分类的形式。
五、高斯过程回归
高斯过程回归 (Gaussian Process Regression) 的目标就是给定
最简单的做法是线性回归(即多项式回归):
或者是 Logistics 回归:
然而,这些方法我们都需要先验地规定数据模型。比如说,Logistics 回归比较适合离散数据,而三角函数回归比较适合周期数据。
我们希望找到一种更加 adaptive 的方法,能够根据数据的特征自动选择合适的模型。
- 把
视为一个高斯过程。 - 估计高斯过程的超参数:均值
和协方差矩阵 。 - 计算条件均值
作为预测值:
我们已经知道,条件均值的形式如下:
其中协方差矩阵的定义为:
然而,我们这里假设了数据是一个高斯过程。如果真实数据并不符合高斯过程假设,那么我们的预测结果就会有误差。
为此,一个重要的技巧是引入核函数
最常见的 kernel 之一是径向基函数 (Radial Basis Function, RBF) 核:
其中,
下面的 Mercer 定理说明了什么样的函数能够作为核函数。
Theorem (Mercer). 设
也就是说,只要某个函数
- 对称性:
- 正定性:
是正定函数。
如果
具有平移不变性,即 (51) 则可以根据 Bochner 定理,判断
的傅里叶变换是否非负来判断 的正定性。
Mercer 定理保证这个函数必然可以表示为某个高维(甚至无穷维)希尔伯特空间中的内积,从而可以作为核函数使用。
六、布朗运动在金融学中的应用
前面我们已经介绍了布朗运动的定义。布朗运动
其中,
此外,布朗运动任意两个时刻的增量服从高斯分布:
布朗运动的一大特点是它的起伏非常大。理论上来说,在任意短的时间内,布朗运动的变化的上界是正无穷,下界是负无穷。因此,布朗运动适合用于预测一些没有趋势的事件,比如说股票价格。
6.1. 几何布朗运动 (Samuelson)
1900 年,Bachelier 的博士论文首次提出使用布朗运动来预测股票价格的变化。后来这被认为是现代金融学的开端。Bachelier 虽然本身不是很有名,但他的老师是大名鼎鼎的庞加莱。
20 世纪 30 年代,Samuelson 提出,由于布朗运动存在负数,因此不太适合直接用来预测股价。因此,他将
6.2. Ito 公式
1944 年,日本数学家伊藤清 (Ito) 在随机分析领域做出了非常重要的工作。在几何布朗运动中,我们需要对
进行研究。在微积分中,根据一阶微分的不变性,其一阶微分可以写为
其中,布朗运动的微分为
因此,我们有
也就是说,这个微分与
由于我们希望刻画的是
基于此,我们能够给出大名鼎鼎的 Ito 公式:
Ito 公式是随机微积分中一个非常重要的成果。借助 Ito 公式,我们可以计算一些随机微积分。比如说:
根据 Ito 公式,我们有
因此,
下面,我们利用 Ito 公式来分析几何布朗运动:
则
6.3. Black-Scholes 方程
在 Ito 公式的基础上,Balck-Scholes-Merton 三人于 1973 年提出了 Black-Scholes 模型,用于期权定价
在金融市场中,一种常见的风险对冲手段是利用卖股票的钱来买期权。这被称为资产组合 (portfolio):
我们希望我们的 portfolio 随着时间的变化能够做到稳赚不赔:
其中
根据 Ito 公式,等式的左侧为
其中,
为了让等式左右两侧相等,就需要把
这种方式称为 Delta 对冲。
此时,我们有:
消去
为了求解这个偏微分方程,我们需要一个初始条件
对于看涨期权,其交易价格应该为:
对于看跌期权,其交易价格应该为:
其中:
-
是标的资产的初始价格。 -
是期权的行权价格。 -
是期权的到期权时间。 -
是无风险利率。 -
是标准正态分布的累积分布函数。 (76) -
和 是 Black-Scholes 模型中的参数。 (77)